13 Prerregistro y transparencia
Traducción literal al castellano del capítulo 13, «Preregistration and Transparency», de Daniël Lakens, Improving Your Statistical Inferences.
Original: https://lakens.github.io/statistical_inferences/13-prereg.html
Licencia del original: CC-BY-4.0. Traducción no oficial.
Desde que los datos se utilizan para respaldar afirmaciones científicas, las personas han intentado presentar selectivamente aquellos datos que encajan con lo que desean que sea cierto. Un ejemplo de científico que hizo esto es Daryl Bem, un parapsicólogo que estudia si las personas poseen una percepción extrasensorial que les permite predecir el futuro. Mediante la comunicación selectiva de resultados y la publicación de nueve estudios en una revista de primer nivel en los que afirmaba que las personas podían predecir el futuro, Bem contribuyó a desencadenar la crisis de replicación en psicología en 2011. En la Figura 13.1 pueden verse los resultados y la discusión de uno de los estudios que realizó (Bem 2011). En este estudio, los participantes pulsaban un botón a la izquierda o a la derecha para predecir si una imagen estaba oculta detrás de una cortina situada a la izquierda o a la derecha. En el momento en que tomaban la decisión, ni siquiera el ordenador había determinado aleatoriamente dónde aparecería la imagen, de modo que cualquier rendimiento superior al azar resultaría muy sorprendente.
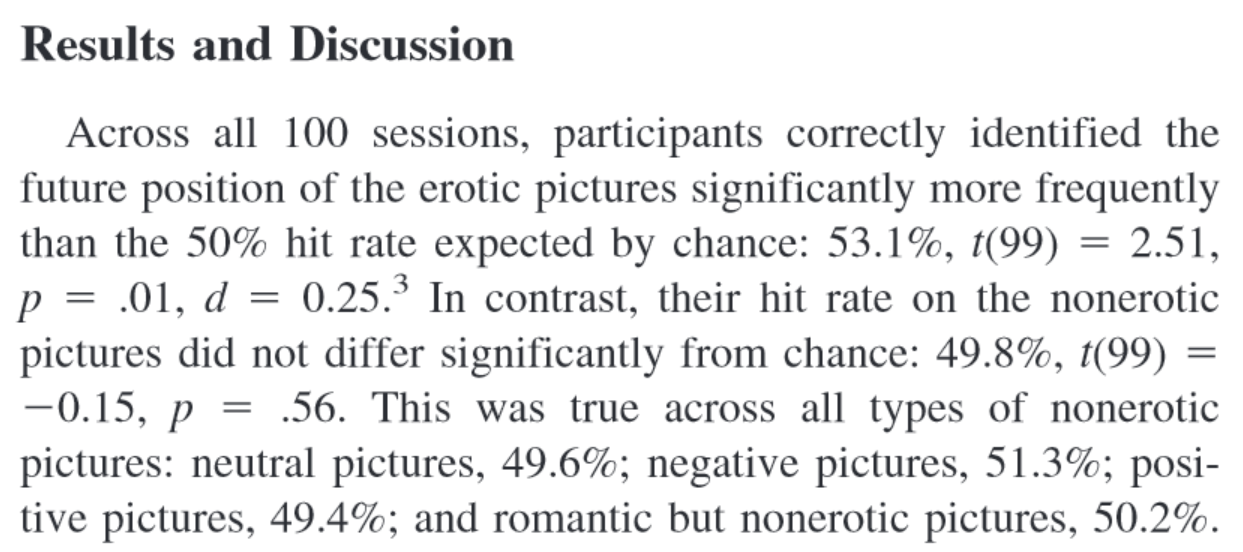
Está claro que hay cinco contrastes frente al nivel de acierto esperado por azar —para imágenes eróticas, neutras, negativas, positivas y «románticas pero no eróticas»—. Una corrección de Bonferroni nos llevaría a utilizar un nivel alfa de 0,01 —un alfa de 0,05 dividido entre cinco contrastes— y el resultado principal, según el cual los participantes adivinaron la posición futura de las imágenes eróticas por encima del azar, con un valor p de 0,013, no habría permitido a Bem rechazar la hipótesis nula si se hubiera utilizado un nivel alfa preespecificado y corregido por comparaciones múltiples.
¿Cuál de las cinco categorías —imágenes eróticas, neutras, negativas, positivas y románticas pero no eróticas— habrías predicho que las personas acertarían por encima del azar si hubiéramos evolucionado hasta adquirir la capacidad de predecir el futuro? ¿Crees que Bem predijo realmente un efecto únicamente para las imágenes eróticas antes de haber visto los datos? Podrías desconfiar de que Bem hubiera predicho un efecto solo para este grupo concreto de estímulos y pensar que estaba «cocinando» los datos —realizando multitud de observaciones y seleccionando el resultado significativo— para después HARKear, es decir, formular la hipótesis después de conocer los resultados (Kerr 1998), en la introducción del estudio. ¿Deberían otros investigadores confiar sin más en que tú habías predicho un resultado comunicado si realizaste un estudio con varias condiciones y encontraste un efecto únicamente en una de ellas? ¿O deberían mostrarse escépticos y dudar de que puedan tomar al pie de la letra las afirmaciones del artículo de Bem?
13.1 Prerregistro del plan de análisis estadístico
En el pasado, los investigadores han propuesto soluciones para evitar el sesgo en la literatura provocado por tasas de error de tipo I infladas como consecuencia de la comunicación selectiva de resultados. Por ejemplo, Bakan (1966) discutió los problemas de decidir si realizar o no un contraste de hipótesis direccional después de observar los datos. Si un investigador decide realizar un contraste direccional únicamente cuando el contraste bilateral produce un valor p entre 0,05 y 0,10 —por ejemplo, si obtiene p = 0,08, decide después de ver el resultado que también estaba justificado un contraste unilateral y comunica p = 0,04, unilateral—, en la práctica la tasa de error de tipo I se duplica: pasa a ser 0,10 en lugar de 0,05. Bakan (p. 431) escribe:
¿Cómo debería manejarse esto? ¿Debería existir algún registro central en el que uno dejara constancia de su decisión de realizar un contraste unilateral o bilateral antes de recoger los datos? ¿Debería uno, como me sugirió en cierta ocasión un eminente psicólogo, enviarse una carta a sí mismo para que el matasellos demostrara que había decidido previamente realizar un contraste unilateral?
De Groot (1969) ya señaló la importancia de «desarrollar de antemano sobre el papel el procedimiento de investigación —o diseño experimental— con el mayor detalle posible». Esto debería incluir «una declaración de los criterios de confirmación, incluida la formulación de hipótesis nulas, si las hubiera, la elección de la(s) prueba(s) estadística(s), el nivel de significación y los intervalos de confirmación resultantes», así como «para cada uno de los detalles mencionados, una breve nota sobre su fundamento, es decir, una justificación de las elecciones concretas del investigador».
El auge de internet ha hecho posible crear registros en línea que permiten a los investigadores especificar el diseño del estudio, el plan de muestreo y el plan de análisis estadístico antes de recoger los datos. Una marca temporal y, en ocasiones, incluso un identificador digital de objetos (DOI) específico comunican de forma transparente a los colegas que la pregunta de investigación y el plan de análisis se especificaron antes de examinar los datos. Algunas herramientas van todavía más lejos, como OpenSafely, que registra todos los análisis realizados y todos los cambios introducidos en el código de análisis. Esto es importante porque no puedes poner a prueba una hipótesis con los mismos datos utilizados para generarla. Si elaboras una hipótesis después de observar los datos, esa hipótesis podría ser cierta, pero todavía no se habrá hecho nada para someterla a una prueba severa. Cuando exploras datos puedes realizar un contraste de hipótesis, pero no puedes poner a prueba una hipótesis.
En algunos campos, como la medicina, actualmente es obligatorio registrar determinados estudios, como los ensayos clínicos. Por ejemplo, el International Committee of Medical Journal Editors establece que exige —y recomienda que todos los editores de revistas médicas exijan— que los ensayos clínicos se registren en un registro público de ensayos antes o en el momento de incluir al primer paciente, como condición para que puedan considerarse para publicación.
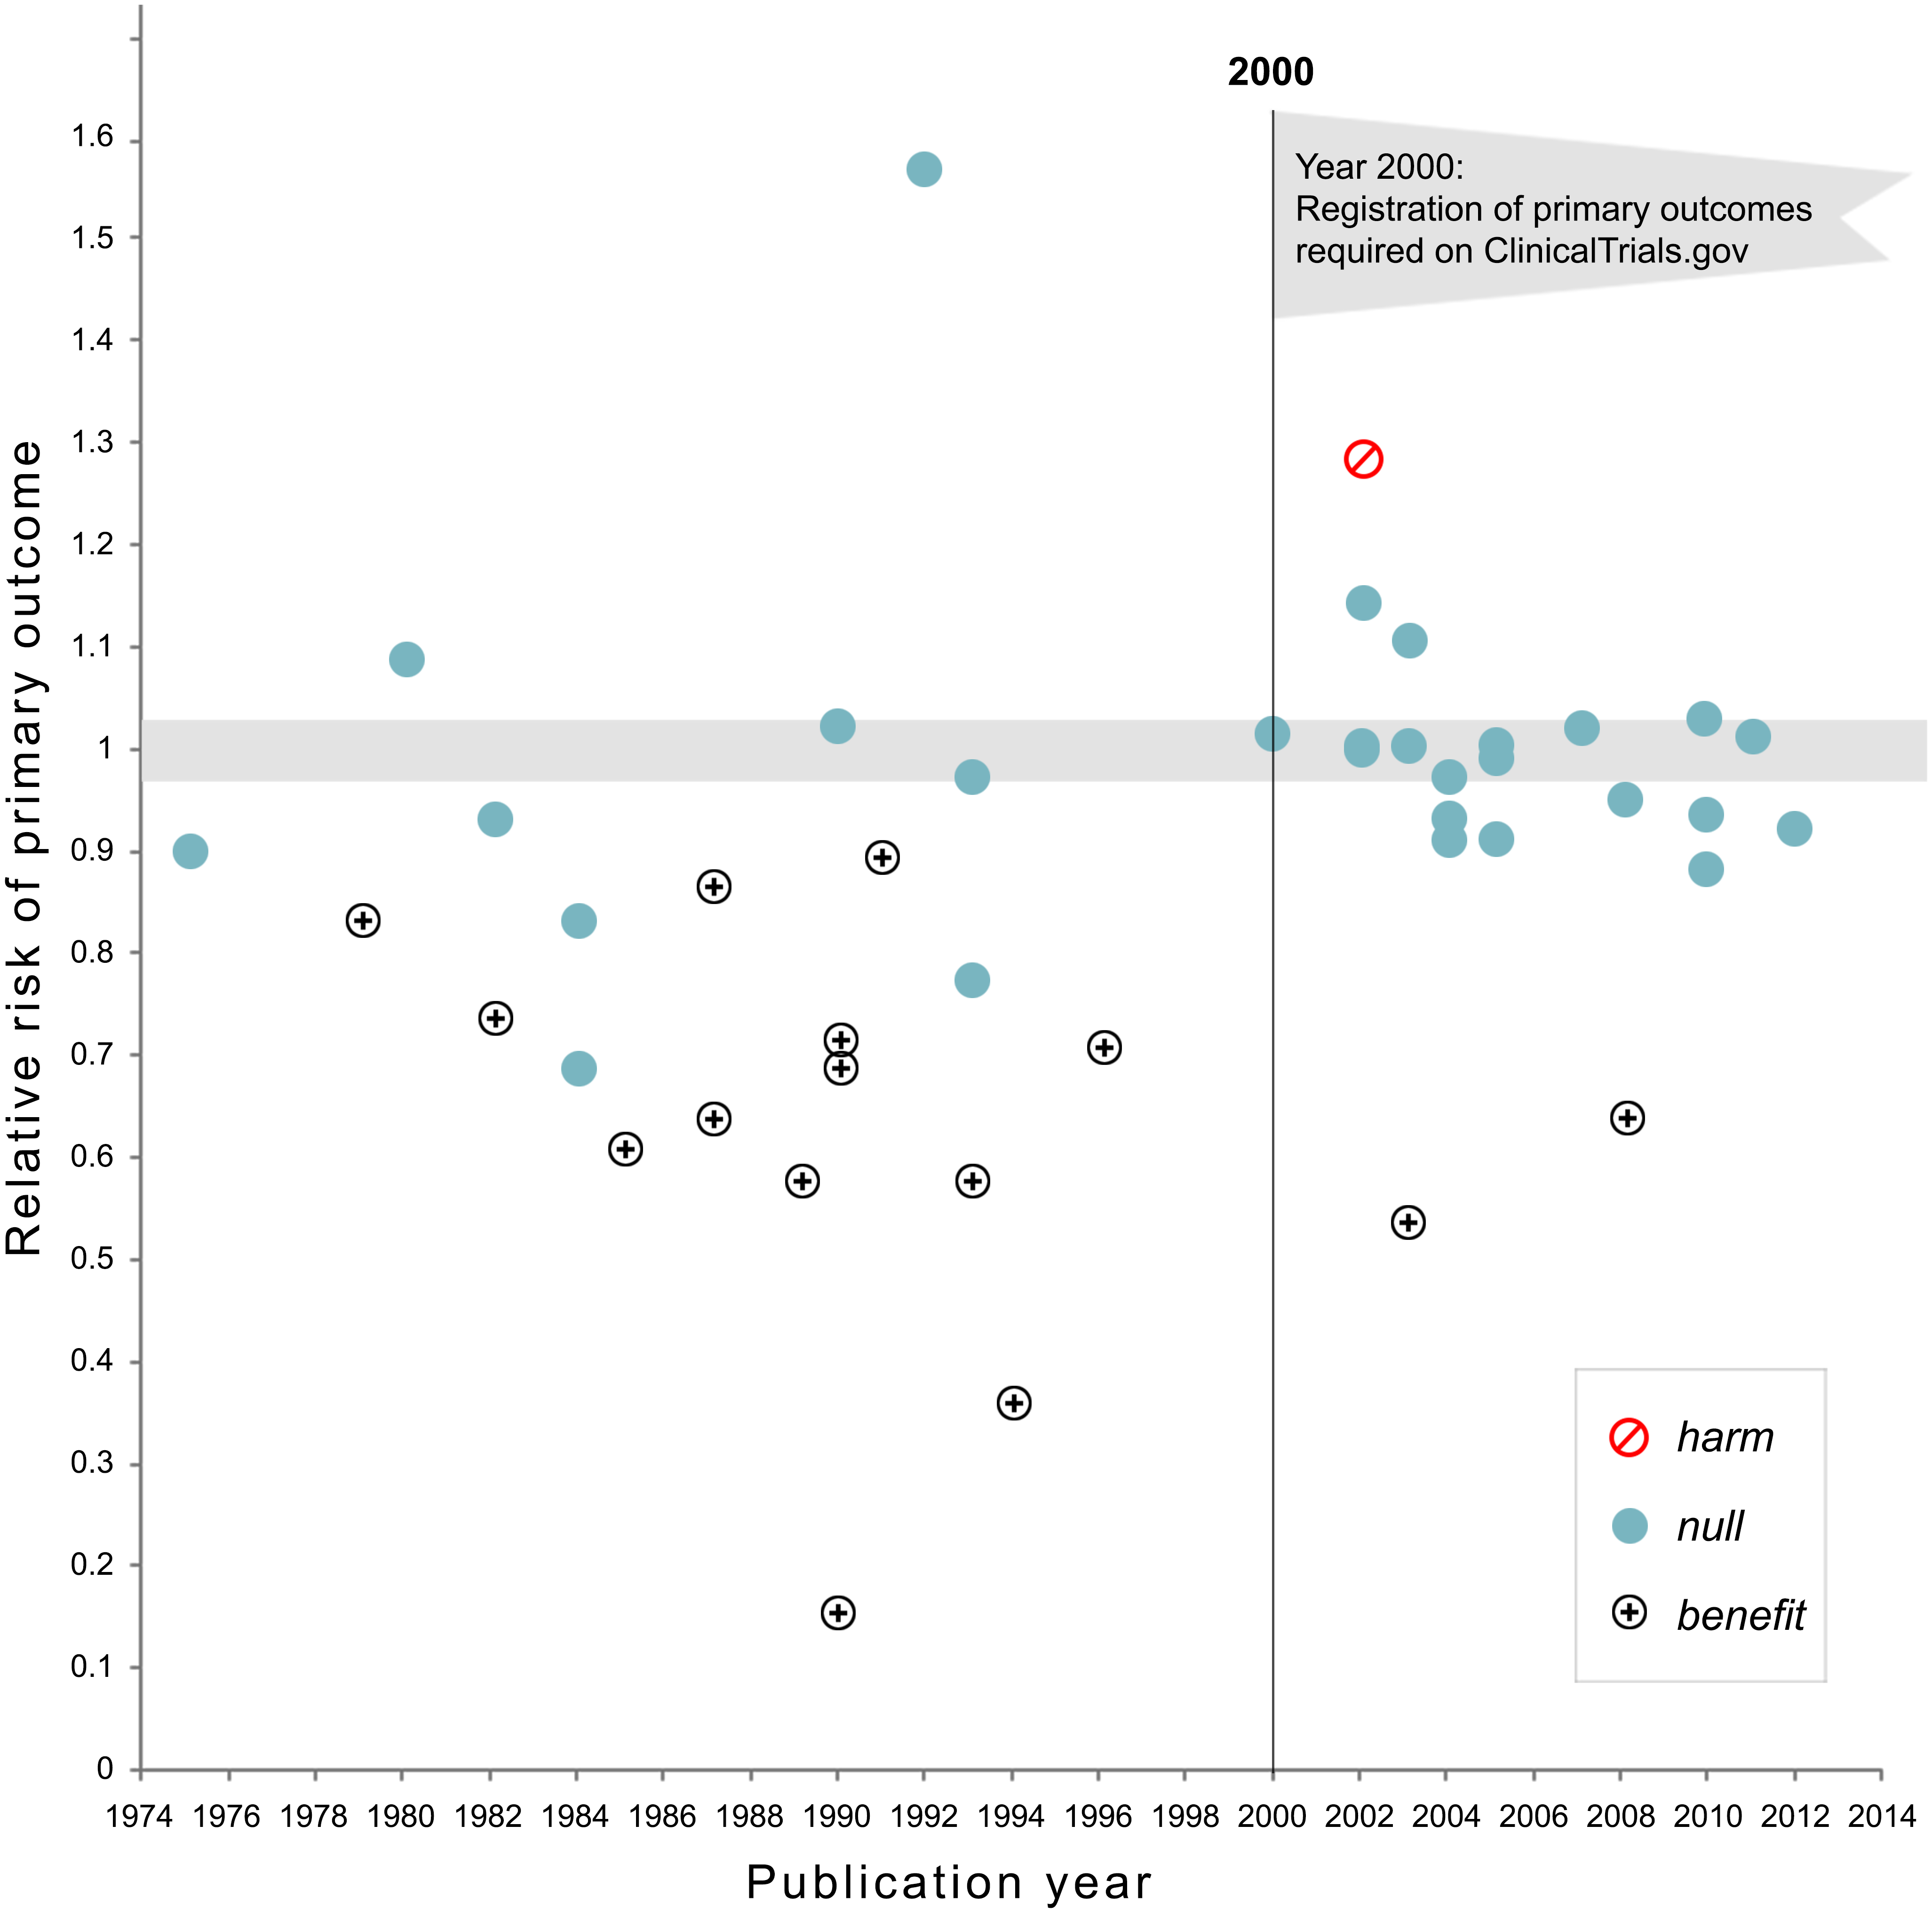
El uso de registros de estudios ha sido promovido por la Food and Drug Administration (FDA) desde 1997. En estos registros se proporcionaba una descripción del estudio e información de contacto con el objetivo principal de facilitar que el público pudiera participar en ensayos clínicos. Desde el año 2000, los registros se han utilizado cada vez más para prevenir el sesgo, y las normas se han vuelto progresivamente más estrictas tanto respecto a la comunicación del resultado primario antes de la recogida de datos como a la actualización del registro con los resultados una vez finalizada la recogida, aunque estas normas no siempre se cumplen (Goldacre et al. 2018).
La obligación de registrar el resultado primario de interés en ClinicalTrials.gov se correlacionó con una reducción sustancial del número de estudios que observaron resultados estadísticamente significativos, lo que podría indicar que eliminar la flexibilidad sobre cómo analizar los datos evitó la comunicación de resultados falsos positivos. Kaplan e Irvin (2015) analizaron los resultados de ensayos controlados aleatorizados que evaluaban fármacos o suplementos dietéticos para el tratamiento o la prevención de enfermedades cardiovasculares. Observaron que 17 de 30 estudios —el 57 %— publicados antes de que fuera obligatorio registrar los estudios en ClinicalTrials.gov produjeron resultados estadísticamente significativos, mientras que solo 2 de 25 —el 8 %— publicados después del año 2000 observaron resultados estadísticamente significativos. Por supuesto, correlación no implica causalidad, por lo que no podemos concluir que exista un efecto causal. Pero si vas al médico porque estás enfermo y el médico te dice que, afortunadamente, existen dos tratamientos, uno cuya eficacia se demostró en un estudio publicado en 1996 y otro en un estudio publicado en 2004, ¿cuál elegirías?
Cuando se implementan perfectamente, los registros de estudios permiten que la comunidad científica conozca los análisis planificados antes de la recogida de datos y el resultado principal de las hipótesis previstas. Sin embargo, esos resultados no necesariamente terminan en la literatura publicada, y este riesgo es especialmente importante en los estudios cuyas predicciones no se confirman (Ensinck y Lakens 2025). Un paso más allá del registro de estudios es un formato de publicación relativamente nuevo conocido como Informes Registrados (Registered Reports). Las revistas que publican Informes Registrados evalúan los estudios a partir de la introducción, el método y los análisis estadísticos, pero no de los resultados (Chambers y Tzavella 2022; Nosek y Lakens 2014). La idea de revisar los estudios antes de recoger los datos no es nueva y se ha propuesto repetidamente durante el último medio siglo (Wiseman et al. 2019). Como vimos en la sección sobre sesgo de publicación, los Informes Registrados presentan una probabilidad sustancialmente mayor de comunicar hallazgos que no apoyan las hipótesis que la literatura científica tradicional (Scheel, Schijen, et al. 2021).
Las ventajas y los inconvenientes de publicar investigaciones como Informes Registrados todavía se están estudiando, pero un número creciente de estudios metacientíficos ha examinado los beneficios del prerregistro y de los Informes Registrados (Lakens et al. 2024). Una ventaja es que los investigadores reciben comentarios de revisores expertos en un momento en el que todavía pueden mejorar el estudio, en lugar de recibirlos una vez recogidos los datos. Trasladar el proceso de crítica de un estudio desde después de realizarlo —como ocurre en la revisión por pares tradicional— hasta antes de realizarlo —mediante Informes Registrados, la implementación de «Red Teams» (Lakens 2020) o consejos de revisión metodológica (Lakens 2023) en las universidades— es una idea que merece explorarse. Podría hacer que el proceso de crítica científica fuera más colaborativo, porque los revisores podrían ayudar a mejorar un estudio en lugar de limitarse a decidir si los defectos de un manuscrito son demasiado importantes como para recomendar su publicación.
13.2 El valor del prerregistro
Los prerregistros son documentos con marca temporal que describen los análisis que los investigadores planean realizar y, al mismo tiempo, comunican de manera transparente que esos análisis no se han seleccionado basándose en información contenida en los datos que determina el resultado de los análisis previstos. El objetivo principal del prerregistro es permitir que otros evalúen de forma transparente la capacidad de una prueba para falsar una predicción, es decir, cuán severamente se ha puesto a prueba una hipótesis (Lakens 2019). La severidad de una prueba viene determinada por la probabilidad de que una predicción se demuestre errónea cuando es errónea y se demuestre correcta cuando es correcta. Durante el proceso de investigación, los investigadores pueden tomar decisiones que aumenten la probabilidad de que su predicción reciba apoyo estadístico incluso cuando es falsa. Por ejemplo, cuando Daryl Bem decidió en cuál de los cinco conjuntos de estímulos centrarse en la sección de resultados, la elección de centrarse únicamente en los estímulos eróticos —en lugar de utilizar la media de todos los estímulos o los estímulos de otra condición, como las imágenes negativas— se justificó únicamente porque el valor p acabó siendo estadísticamente significativo. También puede ocurrir lo contrario: que los investigadores deseen obtener un resultado no significativo y tomen decisiones que aumenten la probabilidad de no corroborar una predicción —por ejemplo, reduciendo la potencia estadística— incluso cuando la predicción era correcta. El objetivo del prerregistro es impedir que los investigadores reduzcan de manera no transparente la capacidad de la prueba para falsar una predicción. Para ello, permite a los lectores ver cómo se planeaba poner a prueba la predicción antes de que los investigadores tuvieran acceso a los datos y evaluar si los cambios respecto al plan original reducen la severidad con la que se puso a prueba la predicción.
El prerregistro aporta valor a quienes, de acuerdo con su filosofía de la ciencia, confían más en las afirmaciones respaldadas por pruebas severas y éxitos predictivos. El prerregistro por sí mismo no hace que un estudio sea mejor o peor que otro no prerregistrado (Lakens 2019). Simplemente permite evaluar de manera transparente la severidad de una prueba. En teoría, la severidad de una prueba no depende de que el estudio esté prerregistrado. En la práctica, sin embargo, siempre que las estructuras de incentivos de la ciencia introduzcan sesgos del investigador, es probable que el prerregistro aumente la severidad de las pruebas. El prerregistro no aportaría valor si el enfoque de análisis correcto estuviera completamente claro tanto para los investigadores como para los lectores, por ejemplo porque la teoría estuviera tan bien especificada que solo existiera un plan de análisis racional. En la mayoría de los campos científicos, no obstante, las teorías rara vez restringen por completo la forma de poner a prueba las predicciones.
A pesar de ello, es importante reconocer que existen casos en los que desviarse de un plan de análisis prerregistrado conduce a una prueba más severa de la hipótesis. Por ejemplo, si tu prerregistro no tuvo en cuenta que algunos participantes podrían estar demasiado ebrios como para responder de manera significativa a la tarea, o si olvidaste especificar qué harías si los datos no siguieran una distribución normal, la mayoría de tus colegas consideraría que cambiar el plan de análisis original produce una prueba más severa y no que se trata de una estrategia para aumentar la probabilidad de encontrar un efecto estadísticamente significativo. Si enumeras de manera transparente todas las desviaciones respecto al plan de análisis y proporcionas justificaciones sólidas, los lectores podrán extraer sus propias conclusiones sobre la severidad con la que se ha puesto a prueba la hipótesis (Lakens 2024).
El prerregistro es una herramienta, y los investigadores que la utilizan deberían hacerlo porque persiguen un objetivo que el prerregistro facilita. Si el uso de una herramienta se desvincula de una filosofía de la ciencia, corre el riesgo de convertirse en una heurística. Los investigadores no deberían prerregistrar porque se haya convertido en una nueva norma, sino porque puedan justificar, a partir de su filosofía de la ciencia, de qué modo el prerregistro favorece sus objetivos. Hay muchos tipos de investigación para los que el prerregistro no es necesario. Aunque siempre es recomendable ser lo más transparente posible al investigar, desde la perspectiva de la filosofía de la ciencia el valor distintivo del prerregistro se limita a aquellas investigaciones cuyo objetivo es someter predicciones a pruebas severas. Fuera de este tipo de investigación, la transparencia —por ejemplo, compartir datos, materiales y un cuaderno de laboratorio que detalle las decisiones tomadas— puede ser valiosa para que otros investigadores puedan evaluar los resultados con mayor detalle. Además de su objetivo principal —permitir que otros evalúen cuán severamente se ha probado una predicción—, los investigadores han señalado beneficios secundarios del prerregistro, como la sensación de que mejoró su diseño experimental, su plan de análisis y sus predicciones teóricas (Sarafoglou et al. 2022). Aunque no es necesario hacer público un prerregistro para obtener estos beneficios, un prerregistro público puede motivar a los investigadores a pensar con más detenimiento en su estudio de antemano. Este uso del prerregistro ya fue señalado por Bakan (1967):
Hace algunos años preparé una conferencia con consejos para estudiantes de posgrado sobre cómo realizar investigación. Mi intención no era en absoluto cínica. Sin embargo, mis estudiantes interpretaban sistemáticamente aquella conferencia como cínica, una reacción que me ayudó a comprender el lamentable estado de la investigación psicológica. El punto principal de la conferencia, repetido en distintas presentaciones sobre el «buen diseño experimental», era que la forma en que se analizarían e interpretarían los datos debía pensarse cuidadosamente antes de recogerlos. Idealmente, sostenía, uno debería poder redactar las secciones que definen el problema, revisan la literatura y explican los métodos exactamente como aparecerían en el informe final. Después podría esbozar las tablas que presentaría y escribir dos o tres versiones diferentes de la discusión, ¡sin haber recogido todavía ningún dato! De hecho, defendía que era un buen ejercicio rellenar las tablas con algunos datos «inventados» para asegurarse de que los datos que finalmente se recogieran pudieran utilizarse para defender las afirmaciones que acabarían formulándose.
13.3 Cómo prerregistrar
Cuanto más detallado sea un documento de prerregistro, más fácil será para otros evaluar de manera transparente la severidad de las pruebas realizadas. Como resulta difícil anticipar todos los aspectos que deberían incluirse, se han creado sitios web que guían a los investigadores durante este proceso —por ejemplo, https://aspredicted.org/—, además de directrices y plantillas (Veer y Giner-Sorolla 2016). La plantilla de Van ’t Veer y Giner-Sorolla constituye un excelente punto de partida para quienes no tienen experiencia prerregistrando su investigación. Otro trabajo útil de Wicherts et al. (2016) ofrece una lista de comprobación de los aspectos que conviene considerar al planificar, ejecutar, analizar y comunicar una investigación.
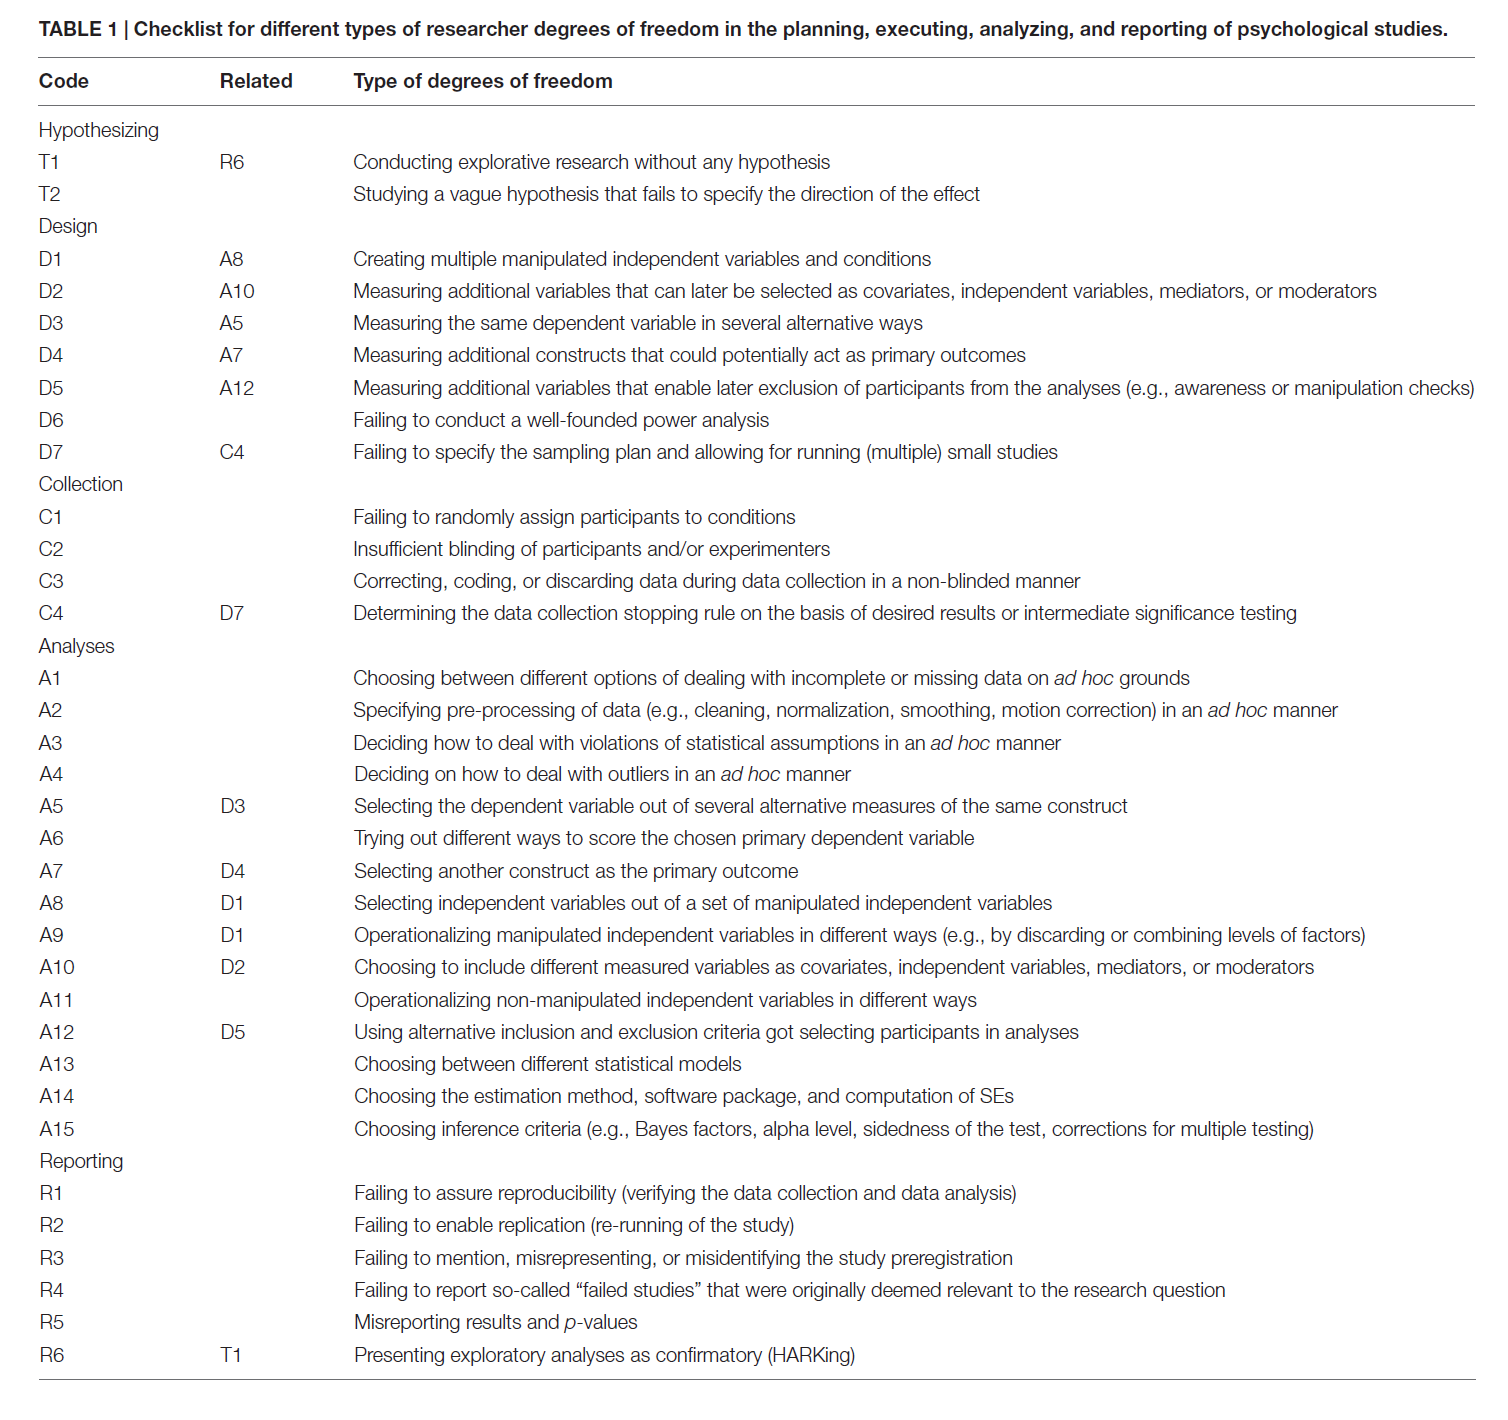
Aunque estas listas fueron útiles para introducir a los científicos en la idea del prerregistro, es importante elevar el listón hasta el nivel necesario para disponer de prerregistros de alta calidad que cumplan realmente su objetivo de permitir a los colegas evaluar la severidad de una prueba. El primer paso consiste en que los autores sigan las directrices de comunicación propias de su campo. En psicología, esto significa seguir los Journal Article Reporting Standards (JARS) (Appelbaum et al. 2018). Estas directrices incluyen más recomendaciones de las necesarias para un documento de prerregistro, pero recomendaría utilizar JARS tanto al redactar el prerregistro como al preparar el informe final, porque constituye un conjunto de recomendaciones muy bien elaborado. Tener en cuenta JARS al planificar o comunicar una investigación probablemente mejore el estudio.
Los Journal Article Reporting Standards indican qué información debe aparecer en la portada, el resumen, la introducción, el método, los resultados y la discusión del artículo. Por ejemplo, JARS establece que en la portada debería añadirse una nota del autor que incluya «información sobre el registro si el estudio ha sido registrado». Las secciones de método y resultados reciben mucha atención en JARS, y también merecen mucha atención en un prerregistro. Recuerda que una prueba severa tiene una alta probabilidad de encontrar un efecto predicho si la predicción es correcta y una alta probabilidad de no encontrarlo si la predicción es incorrecta. Las prácticas que inflan la tasa de error de tipo I aumentan la posibilidad de encontrar un efecto predicho cuando la predicción es en realidad falsa. Una potencia baja, medidas poco fiables, un procedimiento defectuoso o un mal diseño aumentan la posibilidad de no encontrar un efecto cuando la predicción era correcta. Los análisis incorrectos corren el riesgo de responder a una pregunta distinta de la predicción que los investigadores pretendían poner a prueba —lo que a veces se denomina error de tipo III—. Como vemos, JARS pretende abordar estas amenazas a la severidad de una prueba pidiendo a los autores que proporcionen información detallada en las secciones de método y resultados.
13.4 Estándares de comunicación para artículos científicos
Aunque a continuación me centraré en estudios experimentales cuantitativos con asignación aleatoria a condiciones —puedes descargar la tabla de JARS aquí—, JARS incluye tablas para experimentos sin aleatorización, ensayos clínicos, diseños longitudinales, metaanálisis y estudios de replicación. Los siguientes elementos de la tabla JARS son relevantes para un prerregistro:
Describe la unidad de aleatorización y el procedimiento utilizado para generar la secuencia de asignación aleatoria, incluidos los detalles de cualquier restricción —por ejemplo, bloqueo o estratificación—.
Informa de los criterios de inclusión y exclusión, incluida cualquier restricción basada en características demográficas.
Esto evita flexibilidad respecto a qué participantes se incluirán en el análisis final.
- Describe los procedimientos utilizados para seleccionar a los participantes, incluidos:
- el método de muestreo, si se implementó un plan de muestreo sistemático;
- el porcentaje de la muestra contactada que finalmente participó.
A menudo no sabrás qué porcentaje de las personas contactadas acabará participando, y obtener esta información puede requerir algunos datos piloto, ya que quizá no consigas alcanzar el tamaño muestral final deseado —véase más abajo— con el plan de muestreo.
- Describe el tamaño muestral, la potencia y la precisión, incluidos:
- el tamaño muestral previsto;
- la forma en que se determinó el tamaño muestral, incluidos:
- el análisis de potencia o los métodos utilizados para determinar la precisión de las estimaciones de parámetros;
- la explicación de cualquier análisis intermedio y de las reglas de parada utilizadas.
Declarar claramente el tamaño muestral previsto evita prácticas como la parada opcional, que inflan la tasa de error de tipo I. Ten en cuenta —o, si no lo haces, JARS te lo recordará— que puedes acabar con un tamaño muestral obtenido distinto del previsto y que conviene considerar posibles razones por las que quizá no logres recoger la muestra planeada. El tamaño muestral debe justificarse, al igual que los supuestos utilizados en un análisis de potencia: por ejemplo, ¿es realista el tamaño del efecto esperado?, ¿es realmente relevante para otros el menor tamaño del efecto de interés? Si utilizaste análisis secuenciales, especifica cómo controlaste la tasa de error de tipo I mientras analizabas repetidamente los datos a medida que se iban obteniendo.
Como existen distintas formas de justificar el tamaño muestral, recomiendo utilizar la aplicación Shiny en línea que acompaña al capítulo sobre justificación del tamaño de la muestra. Puede encontrarse aquí. La aplicación guía al usuario a través de cuatro pasos.
En primer lugar, los investigadores deben especificar la población de la que extraen la muestra. Para describirla pueden seguir sencillamente las directrices JARS, como los estándares de comunicación para diseños cuantitativos:
Informa de las principales características demográficas —por ejemplo, edad, sexo, etnia y nivel socioeconómico— y de las características importantes específicas del tema —por ejemplo, el nivel de rendimiento en estudios de intervenciones educativas—. En investigación con animales, informa del género, la especie y la cepa u otra identificación específica, como el nombre y la localización del proveedor y la denominación de la población. Indica el número de animales y su sexo, edad, peso, estado fisiológico, estado de modificación genética, genotipo, estado sanitario e inmunitario, exposición previa a fármacos o pruebas y procedimientos anteriores a los que hayan podido ser sometidos. Informa de los criterios de inclusión y exclusión, incluidas las restricciones basadas en características demográficas.
Los investigadores también deberían indicar si pueden recoger datos de toda la población —en cuyo caso la justificación del tamaño muestral está completa— y, si no es así, qué limitaciones de recursos tienen, por ejemplo el tiempo y el dinero disponibles para la recogida de datos.
En el segundo paso, los investigadores deben considerar qué efectos de interés pueden especificar. Idealmente podrán determinar el menor tamaño del efecto de interés, aunque también pueden utilizarse otros enfoques. En el tercer paso se especifica un objetivo inferencial, como contrastar una hipótesis o medir un efecto con precisión. Por último, los investigadores deben indicar el tamaño muestral total —a partir del número de participantes y del número de observaciones por participante— y explicar el valor informativo del estudio: por ejemplo, por qué la muestra es suficientemente grande como para proporcionar una respuesta informativa a la pregunta de investigación. Tras completar los campos pertinentes de la aplicación Shiny, puede descargarse un archivo PDF con una justificación completa del tamaño muestral.
- Describe los diagnósticos de datos planificados, incluidos:
- los criterios para excluir participantes después de recoger los datos, si los hubiera;
- los criterios para decidir cuándo imputar datos ausentes y los métodos de imputación utilizados;
- la definición y el tratamiento de los valores atípicos;
- los análisis de las distribuciones de los datos;
- las transformaciones de datos que se utilizarán, si las hubiera.
Después de recoger los datos, el primer paso consiste en examinar su calidad y comprobar los supuestos de los métodos analíticos planificados. Es habitual excluir datos de participantes que no siguieron las instrucciones, y estos procedimientos de decisión deberían especificarse de antemano. En cada prerregistro descubrirás nuevas consecuencias imprevistas que acabarás incorporando a estas secciones. Si faltan datos, quizá no quieras eliminar por completo a un participante y prefieras utilizar un método para imputarlos. Como los valores atípicos pueden ejercer una influencia desproporcionada sobre los resultados, quizá quieras prerregistrar procedimientos que mitiguen su impacto. Para recomendaciones prácticas sobre cómo clasificar, detectar y gestionar valores atípicos, véase Leys et al. (2019). Si planeas realizar pruebas estadísticas con supuestos determinados —por ejemplo, el supuesto de normalidad en la prueba t de Welch—, debes prerregistrar cómo decidirás si esos supuestos se cumplen y qué harás si no se cumplen.
- Describe la estrategia analítica para la estadística inferencial y la protección frente al error del conjunto del experimento para:
- las hipótesis primarias;
- las hipótesis secundarias;
- las hipótesis exploratorias.
La diferencia entre estos tres niveles de hipótesis no se explica adecuadamente en los materiales de JARS, aunque Cooper (2020) desarrolla algo más la distinción, que sigue siendo bastante imprecisa. Yo distinguiría estas tres categorías del siguiente modo. En primer lugar, un estudio se diseña para responder a una hipótesis primaria. Las tasas de error de tipo I y de tipo II para esta hipótesis se mantienen tan bajas como el investigador pueda permitirse. Las hipótesis secundarias son preguntas que el investigador considera interesantes durante la planificación, pero que no constituyen el objetivo principal. Pueden referirse a variables adicionales recogidas en el estudio o incluso a análisis de subgrupos considerados interesantes desde el principio. Para estas hipótesis, la tasa de error de tipo I sigue controlándose en un nivel que los investigadores consideran justificable. Sin embargo, la tasa de error de tipo II no se controla en los análisis secundarios. El efecto esperado en variables adicionales puede ser mucho menor que el de la hipótesis primaria, o los análisis por subgrupos pueden disponer de tamaños muestrales más pequeños. Por tanto, el estudio proporcionará una respuesta informativa si se observa un efecto significativo, pero un efecto no significativo no podrá interpretarse porque el estudio carecía de potencia —tanto para rechazar la hipótesis nula como para una prueba de equivalencia—. Al etiquetar una pregunta como hipótesis secundaria, el investigador especifica de antemano que los efectos no significativos no conducirán a conclusiones claras.
Por último, queda una categoría residual de análisis que se realizan en un artículo. Yo me referiría a ella como resultados exploratorios, no como hipótesis exploratorias, porque es posible que el investigador ni siquiera hubiera formulado esas hipótesis de antemano y que las pruebas surgieran durante el análisis de los datos. JARS exige que estos resultados se comuniquen «tanto en términos de los hallazgos sustantivos como de las tasas de error que puedan no estar controladas». Un resultado exploratorio puede parecer impresionante a los lectores —o no— dependiendo de sus creencias previas, pero no ha sido sometido a una prueba severa (Ditroilo et al. 2025). Todos los hallazgos necesitan replicarse de forma independiente si queremos construir conocimiento sobre ellos, pero, manteniéndose todo lo demás constante, esta necesidad es aún más inmediata en el caso de los resultados exploratorios.
13.5 Desviarse de un prerregistro
Aunque algunos investigadores consiguen comunicar un estudio realizado exactamente de acuerdo con su prerregistro, muchos se desvían de él cuando llevan a cabo el estudio y analizan los datos (Akker et al. 2023). Entre los motivos frecuentes se encuentran que el tamaño muestral recogido no coincida con el prerregistrado, que se excluyan datos del análisis por razones no especificadas de antemano, que se realice una prueba estadística distinta de la prerregistrada o que se modifique el plan de análisis debido a errores durante la recogida. Se produciría una desviación, por ejemplo, si los investigadores hubieran prerregistrado que analizarían todos los datos pero, después de inspeccionarlos, decidieran excluir un subconjunto de observaciones y utilizaran posteriormente el análisis basado en ese subconjunto como fundamento de su afirmación, ignorando el análisis originalmente previsto.
El objetivo de un contraste estadístico de hipótesis, desde una filosofía estadística del error, es formular afirmaciones válidas que hayan sido sometidas a pruebas severas (Mayo y Spanos 2011). Una razón justificable para desviarse de un plan de análisis prerregistrado es aumentar la validez de la afirmación científica, incluso si esto se produce a costa de reducir la severidad de la prueba. La validez se refiere a «la verdad aproximada de una inferencia» (Shadish et al. 2001). Cuando los investigadores pueden argumentar de forma convincente que el análisis prerregistrado conduce a una prueba estadística de baja validez, una prueba menos severa pero más válida de la hipótesis puede producir una afirmación con mayor verosimilitud o semejanza con la verdad (Niiniluoto 1998).
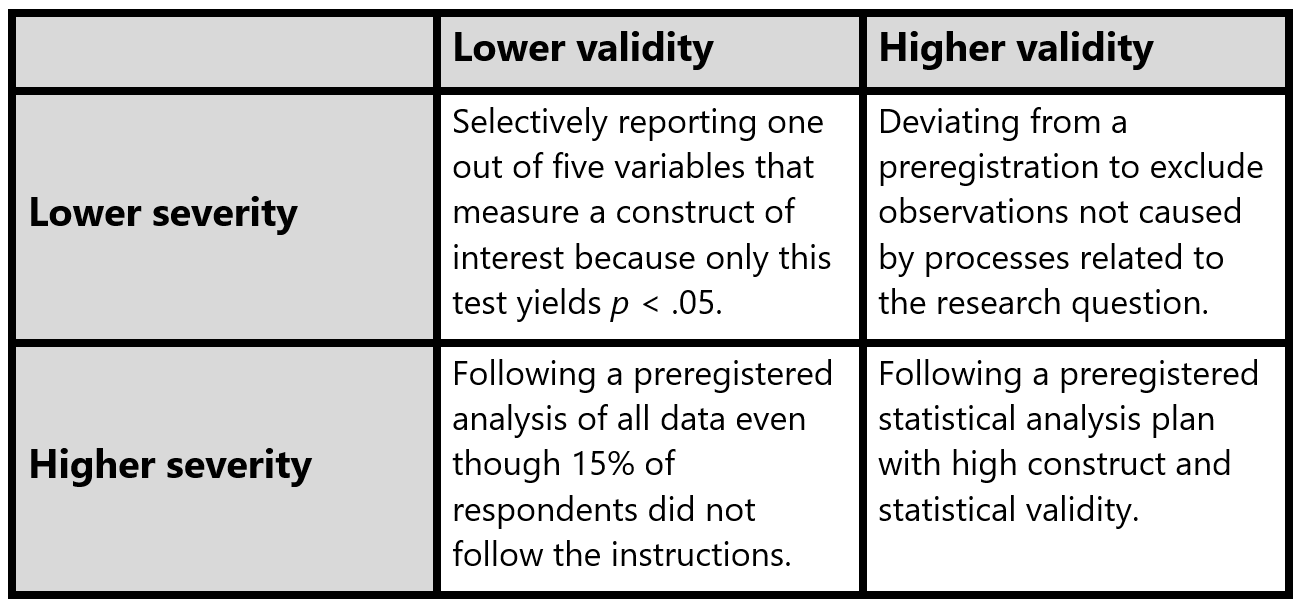
Tanto la validez, que es una propiedad de la inferencia, como la severidad, que es una propiedad de la prueba, son dimensiones continuas. Una prueba estadística puede ser más o menos severa y una inferencia más o menos válida. Es importante señalar que, en la práctica, una afirmación basada en un contraste de hipótesis que contiene una desviación respecto a un prerregistro habrá sido sometida a una prueba más severa que una afirmación basada en un contraste no prerregistrado. Estas desviaciones no deberían limitarse a comunicarse: también deberían evaluarse sus consecuencias. La Figura 13.4 ofrece cuatro ejemplos de pruebas con mayor o menor severidad y de afirmaciones con mayor o menor validez.
Hay distintas razones para desviarse de un prerregistro. Lakens (2024) distingue: 1) acontecimientos imprevistos, 2) errores en el prerregistro, 3) información ausente, 4) violaciones de supuestos no comprobados y 5) falsación de hipótesis auxiliares. Algunas desviaciones no tienen impacto en la severidad de la prueba, mientras que otras la reducen sustancialmente, aunque a menudo las pruebas sigan siendo más severas que las no prerregistradas. En determinadas circunstancias, desviarse de un prerregistro puede incluso aumentar la severidad de una prueba. También puede estar justificado desviarse si hacerlo aumenta la validez de la inferencia. Para cada desviación debe especificarse claramente cuándo, dónde y por qué se produjo, seguido de una evaluación de su impacto sobre la severidad de la prueba —y, cuando sea relevante, sobre la validez de la inferencia—. Existen formularios en línea para comunicar desviaciones, por ejemplo en https://osf.io/6fk87 y https://osf.io/yrvcg.
13.6 ¿Qué aspecto tiene una estrategia analítica formalizada?
Un contraste de hipótesis es un procedimiento metodológico para evaluar una predicción que puede describirse en un nivel conceptual —por ejemplo, «Aprender a prerregistrar mejora tu investigación»—, un nivel operacionalizado —por ejemplo, «Los investigadores que hayan leído este texto controlarán su nivel alfa con mayor cuidado y especificarán con mayor precisión qué corroboraría o falsaría su predicción en un documento de prerregistro»— y un nivel estadístico —por ejemplo, «Una prueba t independiente que compare documentos de prerregistro codificados, escritos por personas que hayan leído este texto, mostrará un número estadísticamente menor de formas de poner a prueba la hipótesis, lo que implica un control más cuidadoso del error de tipo I, en comparación con personas que no hayan leído este texto»—. En un documento de prerregistro, el objetivo debería ser especificar la hipótesis con detalle en el nivel estadístico. Además, cada hipótesis estadística debería estar claramente vinculada con los niveles conceptual y operacionalizado. En algunos estudios se realizan múltiples contrastes y, a menudo, no queda claro qué patrón de resultados falsaría las predicciones de los investigadores. Actualmente los prerregistros difieren mucho en su nivel de detalle, y no todos contienen información suficiente como para tratarlos como pruebas confirmatorias de predicciones (Waldron y Allen 2022).
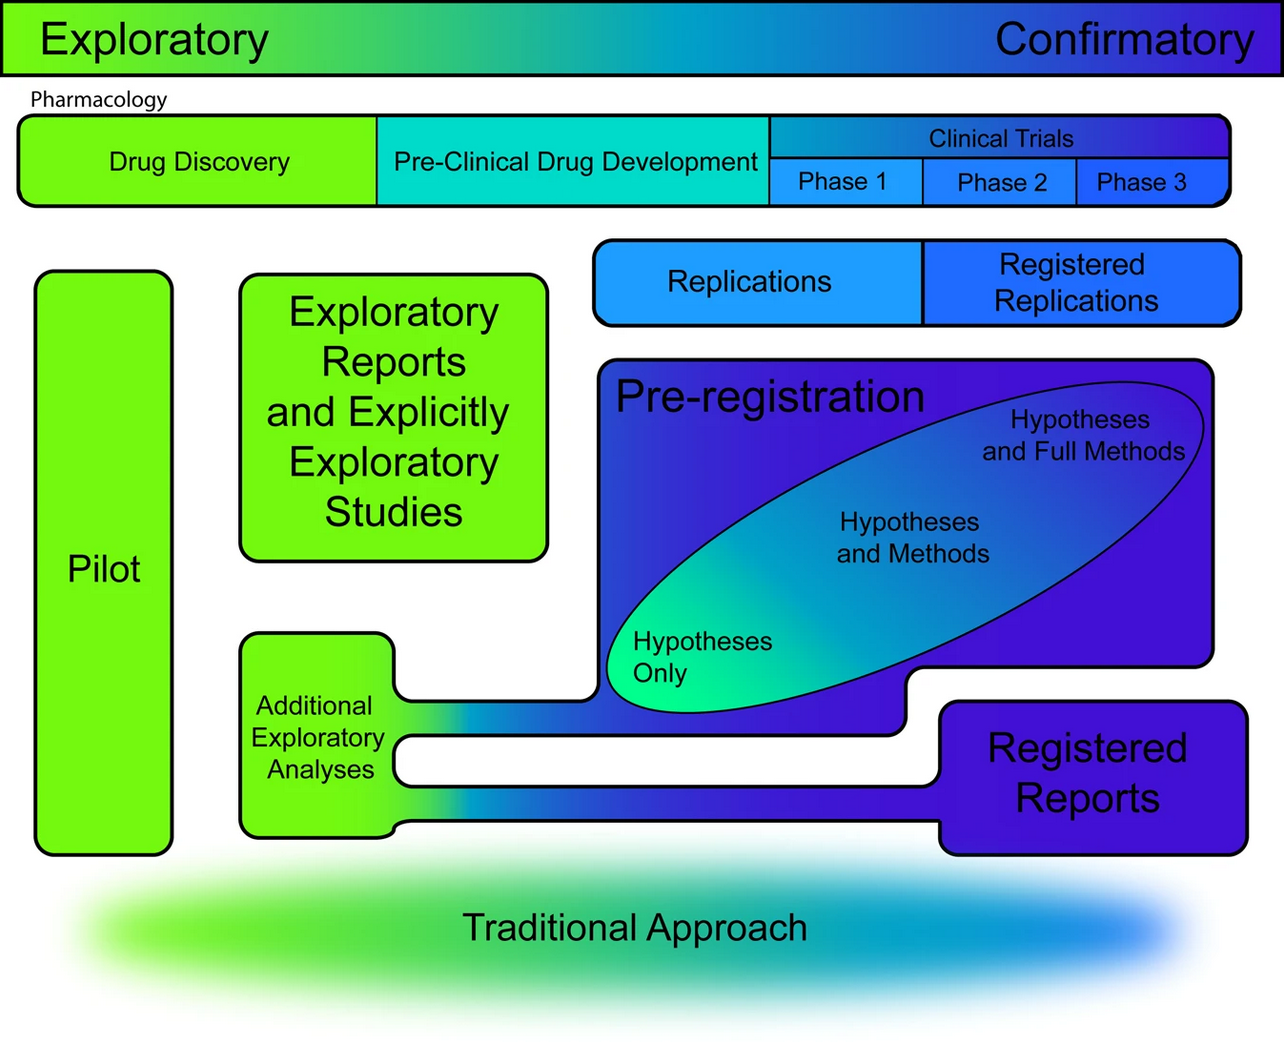
El prerregistro es una práctica relativamente nueva para la mayoría de los investigadores. Por ello no debería sorprender que a menudo exista bastante margen de mejora en la forma de prerregistrar. No basta con prerregistrar: el objetivo es hacerlo con suficiente calidad como para que otros puedan evaluar la severidad con la que pusiste a prueba tu hipótesis. ¿Cómo conseguirlo? En primer lugar, conviene reconocer que describir una hipótesis verbalmente es difícil. Del mismo modo que utilizamos notación para describir estadísticos porque elimina ambigüedad, las descripciones verbales de hipótesis rara vez restringen suficientemente la flexibilidad potencial del análisis de datos.
Por ejemplo, en la descripción verbal de la hipótesis estadística del párrafo anterior —«Una prueba t independiente que compare documentos de prerregistro codificados, escritos por personas que hayan leído este texto, mostrará un número estadísticamente menor de formas de poner a prueba la hipótesis, lo que implica un control más cuidadoso del error de tipo I, en comparación con personas que no hayan leído este texto»— no queda claro qué nivel alfa pienso utilizar para la prueba t ni si realizaré la prueba t de Student o la prueba t de Welch. Los investigadores suelen tratar implícitamente un p > 0,05 como si falsara una predicción, pero se trata de una concepción errónea habitual de los valores p, y con frecuencia una hipótesis se falsa mejor mediante una prueba estadística capaz de rechazar la presencia de resultados predichos, como una prueba de equivalencia. Especificar explícitamente cómo se evaluará una hipótesis deja claro de qué manera podrá demostrarse errónea la predicción.
Lakens y DeBruine (2020) explican que una buena forma de eliminar la ambigüedad de un contraste de hipótesis descrito en un prerregistro es asegurarse de que sea legible por máquinas. Las máquinas son notoriamente malas manejando descripciones ambiguas, así que si una máquina puede entender la hipótesis, probablemente estará especificada con claridad. Una hipótesis se pone a prueba mediante un análisis que recibe datos como entrada y devuelve resultados. Algunos de esos resultados se comparan con criterios, que se utilizan para la evaluación del resultado del contraste. Imagina, por ejemplo, una hipótesis que predice que la media de un grupo será mayor que la media de otro. Los datos se analizan mediante una prueba t de Welch y, si el valor p resultante es menor que un alfa establecido como criterio —por ejemplo, 0,01—, la predicción se evalúa como corroborada. Nuestra predicción queda falsada si podemos rechazar, mediante una prueba de equivalencia, efectos considerados lo bastante grandes como para importar, y el resultado es inconcluso en caso contrario. En un prerregistro claro de un contraste de hipótesis, todos estos componentes —el análisis, la comparación de los resultados con los criterios y la evaluación de los resultados en términos de corroborar o falsar la predicción— estarán especificados con claridad.
La forma más transparente de especificar la hipótesis estadística consiste en utilizar código de análisis. El patrón oro para un prerregistro es crear un conjunto de datos simulado que se parezca a los datos que planeas recoger y escribir un script de análisis que pueda ejecutarse sobre el conjunto de datos que recogerás. Simular datos puede parecer difícil, pero existen excelentes paquetes para hacerlo en R y cada vez hay más tutoriales. Como de todos modos tendrás que realizar los análisis, hacerlos antes de recoger los datos te obliga a pensar cuidadosamente en el experimento. Al prerregistrar el código de análisis te aseguras de que todos los pasos del análisis queden claros, incluidas las comprobaciones de supuestos, la exclusión de valores atípicos y el análisis exacto que planeas realizar —con cualquier parámetro que deba especificarse para la prueba—. Pueden consultarse ejemplos en https://osf.io/un3zx, https://osf.io/c4t28 y en la sección 25 de https://osf.io/gjsft/.
Además de compartir el código de análisis, debes especificar cómo evaluarás el resultado cuando ese código se ejecute sobre los datos que recojas. A menudo esto no se hace explícito en los prerregistros, pero es una parte esencial de un contraste de hipótesis, especialmente cuando existen varias hipótesis primarias, como en nuestra predicción de que «Los investigadores que hayan leído este texto mejorarán el control de su nivel alfa y especificarán con mayor claridad qué corroboraría o falsaría su predicción». Si la hipótesis realmente predice que deben producirse ambos resultados, entonces la evaluación debería especificar que la predicción queda falsada si solo aparece uno de los dos efectos.
13.7 ¿Estás preparado para prerregistrar un contraste de hipótesis?
Es frecuente que la teoría que utilizas para formular predicciones no sea suficientemente sólida como para conducir a hipótesis falsables. Especialmente al comienzo de una línea de investigación existen demasiadas incertidumbres sobre qué análisis realizaremos o qué efectos serían demasiado pequeños como para importar. En estas fases es más habitual adoptar un enfoque cíclico en el que los investigadores realizan un experimento para ver qué ocurre, utilizan lo aprendido para reformular la teoría y diseñan otro experimento. El filósofo de la ciencia Bas van Fraassen resume esta idea con la afirmación de que «la experimentación es la continuación de la construcción teórica por otros medios». Durante este proceso, a menudo necesitamos comprobar si se cumplen determinados supuestos. Esto requiere con frecuencia pruebas de hipótesis auxiliares sobre las medidas y manipulaciones que utilizamos (Uygun Tunç y Tunç 2022).
Mientras preparas un documento de prerregistro puedes encontrarte con muchas incertidumbres que no sabes exactamente cómo resolver. Tal vez sea una señal de que todavía no estás preparado para prerregistrar una predicción. Cuando contrastamos hipótesis, corroborar una predicción debería resultar impresionante y falsarla debería tener consecuencias para la teoría que estamos poniendo a prueba. Si tomas decisiones arbitrarias mientras escribes tus predicciones, la prueba puede no ser ni impresionante ni relevante. A veces simplemente quieres recoger datos para describirlos, examinar la relación entre variables o explorar condiciones límite sin poner nada a prueba. Si ese es el caso, no te sientas obligado a meterte en la camisa de fuerza del contraste de hipótesis (Scheel, Tiokhin, et al. 2021). Naturalmente, un estudio así tampoco permite formular afirmaciones que hayan sido sometidas a pruebas severas, pero ese no debería ser el objetivo de todos los estudios, especialmente en las líneas de investigación nuevas.
13.8 Evalúate
En este ejercicio recorreremos los pasos necesarios para completar un prerregistro de alta calidad. El ejercicio continuará en el capítulo siguiente, donde nos centraremos en un flujo de análisis computacionalmente reproducible y en la implementación de prácticas de ciencia abierta, como compartir datos y código. La ciencia abierta es un conjunto de prácticas orientadas a la reproducibilidad, la transparencia, el intercambio y la colaboración, basadas en la apertura de datos y herramientas que permite a otros reutilizar y examinar críticamente la investigación. Puedes realizar este ejercicio con un proyecto de investigación real en el que participes. Si no estás implicado en ningún proyecto, puedes llevar a cabo un estudio sencillo analizando datos públicamente accesibles. Lo ilustraré mediante una hipótesis que puede responderse a partir de las valoraciones de películas de la Internet Movie Database (IMDB). Puedes formular cualquier hipótesis que quieras utilizando otra fuente de datos, pero no dediques demasiado tiempo a recogerlos, ya que ese no es el objetivo del ejercicio.
Para organizar el prerregistro puedes seguir plantillas creadas por otros investigadores, disponibles en https://osf.io/zab38/wiki/home/. La plantilla predeterminada de prerregistro del OSF es adecuada para estudios de contraste de hipótesis. Ten presentes las directrices JARS mientras redactas el prerregistro.
Una de mis películas favoritas es El club de la lucha (Fight Club). Está protagonizada por Brad Pitt y Edward Norton. En un nivel conceptual, mi hipótesis es que Brad Pitt y Edward Norton son dos grandes actores y que, precisamente por serlo, las películas en las que participan son igual de buenas. En un nivel operacionalizado, mi hipótesis es que, en promedio, las películas protagonizadas por Brad Pitt y Edward Norton recibirán la misma valoración en la Internet Movie Database. IMDB proporciona tanto una puntuación propia como un Metascore procedente de metacritic.com.
Operacionalizaré las valoraciones de las películas mediante las puntuaciones de IMDB, y consideraré como películas protagonizadas por Brad Pitt o Edward Norton todas aquellas en las que hayan aparecido de acuerdo con las siguientes búsquedas de IMDB.
Para Brad Pitt:
Para Edward Norton:
P1: Escribe tu hipótesis en un nivel conceptual. En algunas áreas de investigación quizá puedas expresar esta hipótesis mediante un modelo cuantitativo formal, pero con mayor frecuencia la describirás verbalmente. Intenta ser lo más preciso posible, aunque todas las descripciones verbales de hipótesis tienen limitaciones inherentes. También es útil indicar si los datos ya se han recogido o no y explicar si tu hipótesis está influida por algún conocimiento sobre ellos —en un prerregistro típico, los datos todavía no se habrán recogido—.
P2: Escribe tu hipótesis en un nivel operacionalizado. Deben especificarse claramente todas las variables del estudio —es decir, las variables independientes y/o dependientes—.
Los siguientes pasos consisten en especificar la hipótesis en un nivel estadístico. A veces los recursos disponibles limitan las preguntas estadísticas que podemos responder. Cuando esto ocurre, resulta útil realizar primero una justificación del tamaño muestral. Si los recursos no imponen esta limitación, suele ser más útil especificar primero la pregunta estadística y calcular después el tamaño muestral necesario. Como ya sé que el número de películas en las que aparecen Brad Pitt y Edward Norton es limitado, comenzaré por justificar el tamaño muestral.
P3: Justifica tu tamaño muestral. Utilizaré mi propia aplicación Shiny para recorrer los pasos de una justificación del tamaño de la muestra.
1.1 Describe la población de la que extraes la muestra
La población está formada por todas las películas protagonizadas por Brad Pitt y Edward Norton —hasta marzo de 2023— desde el comienzo de sus respectivas carreras, según aparecen indexadas en la Internet Movie Database (www.imdb.com). El número total de observaciones está limitado por las películas en las que Brad Pitt y Edward Norton habían aparecido hasta esa fecha: 62 y 39, respectivamente.
1.2 ¿Puedes recoger datos de toda la población?
Sí.
El número total de observaciones está limitado por las películas en las que Brad Pitt y Edward Norton han aparecido hasta la fecha: 62 y 39, respectivamente.
2. ¿Qué tamaños del efecto son de interés?
El menor tamaño del efecto de interés siempre es objeto de discusión entre colegas. En este caso, personalmente considero que una diferencia en las valoraciones inferior a 0,5 puntos en una escala de 10 —como la utilizada por IMDB— es suficientemente pequeña como para respaldar mi predicción de que las películas de Brad Pitt y Edward Norton son igual de buenas. En otras palabras, si la diferencia bruta es mayor que −0,5 y menor que 0,5, concluiré que los dos conjuntos de películas reciben valoraciones igualmente buenas.
El efecto mínimo estadísticamente detectable dado el número de películas —62 y 39— puede calcularse examinando el efecto para el que tenemos un 50 % de potencia en una prueba t independiente, por ejemplo con G*Power. Antes de calcular el efecto mínimo estadísticamente detectable debemos especificar nuestro nivel alfa. Sabemos que el tamaño muestral es limitado y que la potencia estadística será un problema. Al mismo tiempo, necesitamos tomar una decisión con los datos disponibles, ya que pasarán muchos años antes de que podamos disponer de una muestra mayor. En un contexto como este, en el que el tamaño muestral es fijo y debe tomarse una decisión, es razonable equilibrar los errores de tipo I y tipo II mediante un análisis de potencia de compromiso. A continuación determinamos que un nivel alfa de 0,15 constituye una decisión defendible. Esto significa que tendremos una probabilidad relativamente alta de concluir incorrectamente que los dos grupos de películas reciben la misma valoración, pero aceptamos ese riesgo para reducir la probabilidad de concluir incorrectamente que las películas no reciben la misma valoración cuando en realidad sí la reciben.
-- Domingo, 5 de marzo de 2023 -- 12:19:19

t tests - Means: Difference between two independent means (two groups)

Analysis: Sensitivity: Compute required effect size

Input:  Tail(s) = Two
        α err prob = 0.15
        Power (1-β err prob) = 0.5
        Sample size group 1 = 62
        Sample size group 2 = 39

Output: Noncentrality parameter δ = 1.4420104
        Critical t = 1.4507883
        Df = 99
        Effect size d = 0.2947141
El efecto mínimo estadísticamente detectable es, por tanto, d = 0,295.
Un análisis de sensibilidad muestra que, dado el tamaño muestral que podemos recoger —n = 62 y 39—, el menor tamaño del efecto de interés —medio punto en la escala— y suponiendo una desviación típica de las valoraciones de sd = 0,9 —una estimación basada en datos piloto—, la potencia estadística es del 91 % si suponemos que la diferencia en las valoraciones es exactamente 0. Es posible que las valoraciones difieran ligeramente y que la diferencia real no sea exactamente 0. Si suponemos una diferencia verdadera de 0,1, la potencia sigue siendo del 86 %. Esta potencia razonable es consecuencia directa de haber aumentado el nivel alfa. Con una tasa de error de tipo I del 5 %, la potencia sería del 64 % —suponiendo una diferencia real entre películas de 0,1— y la tasa de error combinada sería ((100 − 64) + 5) = 41 %. Al aumentar alfa al 15 %, la tasa de error combinada desciende a ((100 − 86) + 15) = 29 %, lo que reduce la probabilidad de cometer un error si suponemos que H0 y H1 tienen la misma probabilidad de ser verdaderas.
TOSTER::power_t_TOST(
  n = c(62, 39),
  delta = 0.1,
  sd = 0.9,
  low_eqbound = -0.5,
  high_eqbound = 0.5,
  alpha = 0.05,
  type = "two.sample"
)
Podemos concluir que tendremos una potencia razonable para la prueba planificada, dado nuestro menor tamaño del efecto de interés y nuestro nivel alfa elevado.
3. Objetivo inferencial
Nuestro objetivo inferencial es realizar una prueba estadística controlando las tasas de error y, por tanto, planeamos tomar una decisión. Utilizamos el análisis de sensibilidad anterior para justificar nuestras tasas de error, aunque también podríamos haber empleado un análisis de potencia de compromiso minimizando más formalmente la tasa de error combinada (Maier y Lakens 2022).
4. Valor informativo del estudio
Por último, evaluamos el valor informativo del estudio. En primer lugar, utilizamos todos los datos disponibles y hemos intentado reducir la tasa combinada de errores de tipo I y tipo II equilibrando en cierta medida ambas tasas. Nuestro objetivo es tomar una decisión a partir de los datos disponibles. La decisión tiene una probabilidad relativamente alta de ser errónea, pero el valor del estudio consiste en permitirnos decidir lo mejor posible dadas las limitaciones de los datos. Por tanto, si alguien quiere saber si las películas protagonizadas por Brad Pitt y Edward Norton son realmente igual de buenas, nuestros resultados ofrecerán la mejor respuesta disponible actualmente, aunque después del estudio siga existiendo una incertidumbre considerable.
P4: Escribe tu hipótesis en un nivel estadístico y especifica el código del análisis. Sé tan concreto como sea posible. Revisa las recomendaciones JARS anteriores y la lista de comprobación de Wicherts et al. (2016) para asegurarte de que no has omitido ningún detalle que debas especificar —por ejemplo, cómo preprocesarás los datos, qué versión del software utilizarás, etc.—.
Ahora podemos especificar en un nivel estadístico la prueba que planeamos realizar. No esperamos datos ausentes ni valores atípicos y analizaremos todas las valoraciones mediante una prueba de equivalencia con límites de equivalencia de −0,5 y 0,5 y un nivel alfa de 0,15. Como los tamaños de los grupos son desiguales, utilizaremos la prueba t de Welch, que no presupone igualdad de varianzas (Delacre et al. 2017). El siguiente código de análisis —que ejecutaré en R 4.2.0 y con la versión 0.4.1 del paquete TOSTER— presupone que los datos estarán almacenados en el data frame imdb_ratings, con una columna para las valoraciones de Brad Pitt llamada brad_pitt_score y otra para las valoraciones de Edward Norton llamada edward_norton_score.
TOSTER::t_TOST(
  x = imdb_ratings$brad_pitt_score,
  y = imdb_ratings$edward_norton_score,
  low_eqbound = -0.5,
  high_eqbound = 0.5,
  eqbound_type = "raw",
  alpha = 0.15,
  var.equal = FALSE
)
Por último, debemos especificar los criterios y cómo evaluaremos los resultados. La función t_TOST también realizará un contraste de significación de la hipótesis nula, lo que resulta conveniente porque podemos considerar respaldada nuestra hipótesis si la prueba de equivalencia es significativa con p < 0,15 o si el intervalo de confianza del 70 % cae completamente dentro de los límites de equivalencia. Podemos considerar falsada la hipótesis si el contraste de significación de la hipótesis nula es significativo con p < 0,15. Si ninguno de los dos contrastes es significativo, los resultados son inconclusos. Si ambos son significativos, la hipótesis también queda falsada, porque existe un efecto, aunque sea demasiado pequeño como para importar. De manera más formal, nuestra hipótesis queda corroborada si TOST p < 0,015 y NHST p > 0,015; queda falsada si NHST p < 0,015; y es inconclusa en cualquier otro caso.
Hemos completado el prerregistro de un estudio muy sencillo. En estudios reales, el proceso de prerregistro a menudo no es tan fácil. Justificar el tamaño muestral suele requerir cierto conocimiento sobre las variables del análisis, los análisis de potencia se vuelven más inciertos cuanto más complejo es el análisis y puede resultar difícil tomar decisiones sobre el preprocesamiento de los datos y el tratamiento de valores atípicos. Si tienes dificultades con tu prerregistro, quizá simplemente todavía no estés preparado para prerregistrar. Puede que tu investigación aún no se encuentre en una fase de estrechamiento, equivalente a una fase 3 de los ensayos clínicos, y que necesites realizar más investigación descriptiva antes de poder llevar a cabo una verdadera prueba de tu hipótesis.
13.8.1 Aspectos prácticos de un prerregistro en línea
En los últimos años se han creado varios servicios en línea que permiten prerregistrar un plan de hipótesis. Explicaré tres soluciones: ZPID, OSF y AsPredicted. En ese orden, estos tres servicios difieren en lo alto que sitúan el listón para que los investigadores puedan prerregistrar en su plataforma. ZPID está específicamente orientado a la ciencia psicológica, OSF es accesible para cualquiera y AsPredicted exige una dirección de correo electrónico perteneciente a una institución académica.
Si prerregistras un estudio, el prerregistro quedará archivado. Esto tiene un coste en tiempo —en ZPID, debido a las comprobaciones manuales— y en dinero —por el almacenamiento de datos a largo plazo—. Solo deberías prerregistrar estudios reales, aunque AsPredicted permite utilizar trabajos de clase como prerregistros. Para un ejercicio es suficiente guardar un archivo PDF que contenga toda la información relacionada con el prerregistro, sin crear realmente una versión con marca temporal en una de estas bases de datos.
13.8.2 Prerregistro en PsychArchives mediante ZPID
Ve a https://pasa.psycharchives.org. Inicia sesión con tu ORCID si tienes uno o puedes crearlo —algo que debería estar al alcance de la mayoría de las personas que trabajan o estudian en una institución de investigación—, o crea una cuenta específica de Leibniz Psychology.
Haz clic en «Start a new submission».
Desplázate hacia abajo hasta la opción de prerregistro y haz clic en ella.
Verás una recomendación para enviar el prerregistro en formato PDF/A. Se trata de un PDF que no permite determinadas restricciones que dificultan el archivo a largo plazo. Esto ya muestra cómo PsychArchives te pedirá que cumplas ciertos estándares que considera buenas prácticas y en los que quizá no habrías pensado por tu cuenta. ¡Eso es algo positivo!
En Microsoft Word puedes guardar un archivo como PDF compatible con PDF/A seleccionando «Archivo» > «Guardar como», eligiendo PDF en el menú desplegable y haciendo clic en «Más opciones…» bajo ese menú.
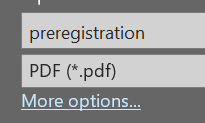
Haz clic en el botón «Opciones…».
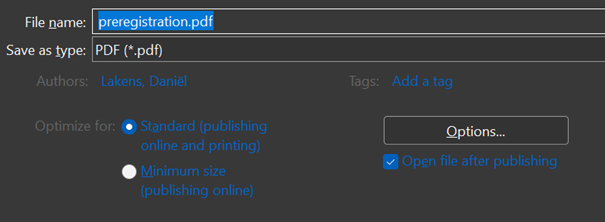
Y marca la casilla «Compatible con PDF/A».
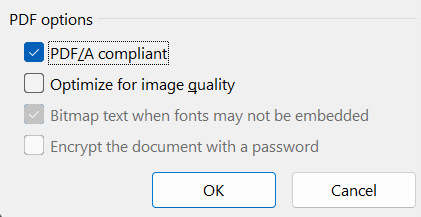
Al abrir un PDF compatible con PDF/A, algunos lectores de PDF mostrarán un mensaje de advertencia.

Haz clic en «Next». Ahora puedes subir un documento de prerregistro. PsychArchives te animará a añadir descripciones y metadatos a los archivos.
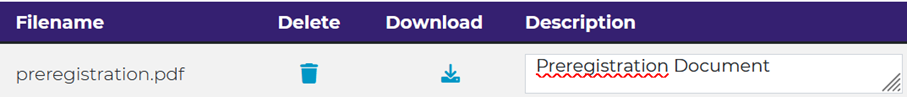
A continuación eliges un nivel de uso compartido —el nivel 0 significa que el archivo es de uso público y el nivel 1 que solo puede utilizarse con fines científicos— y una licencia. Haz clic en «Save and Next».
Ahora vemos por qué PsychArchives sitúa el listón más alto que algunos otros servicios: debemos especificar metadatos para nuestro archivo. Estos metadatos harán que los archivos que compartimos —como un prerregistro, el artículo basado en él y los datos y el código utilizados— sean más fáciles de encontrar, algo importante si la comunidad científica quiere aprovechar en el futuro los beneficios de la ciencia abierta. Este prerregistro todavía no está vinculado a otros archivos, pero en un proyecto real las futuras entregas a PsychArchives se enlazarían con él. Añadir buenas descripciones también ayuda a que otras personas encuentren los archivos en el futuro.
Cuando envíes el prerregistro verás que será revisado manualmente. El personal de PsychArchives comprobará que el envío cumple todas las directrices. Si no es así, te indicará qué debes mejorar y tendrás que volver a enviar el archivo. Ten en cuenta que esta comprobación se refiere a los archivos subidos y a sus metadatos: ¡el personal no comprueba la calidad del prerregistro!
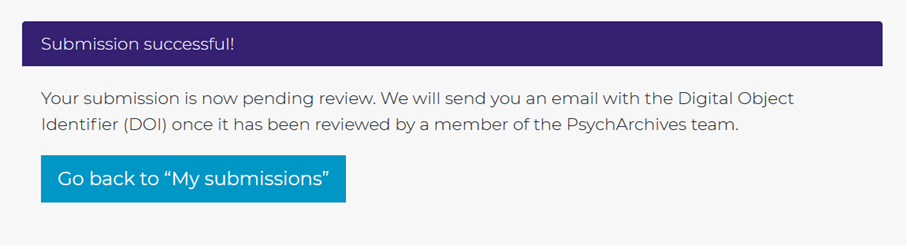
Puedes consultar el prerregistro de PsychArchives mediante el siguiente identificador persistente: https://doi.org/10.23668/psycharchives.12575.
13.8.3 Prerregistro en Open Science Framework
Ve a www.osf.io, crea una cuenta o inicia sesión y haz clic en «Create new project». Introduce un título. Si estás en Europa y quieres ajustarte a la normativa de privacidad del RGPD, asegúrate de seleccionar «Germany» como ubicación de almacenamiento. Haz clic en «Create» y después en «Go to project».
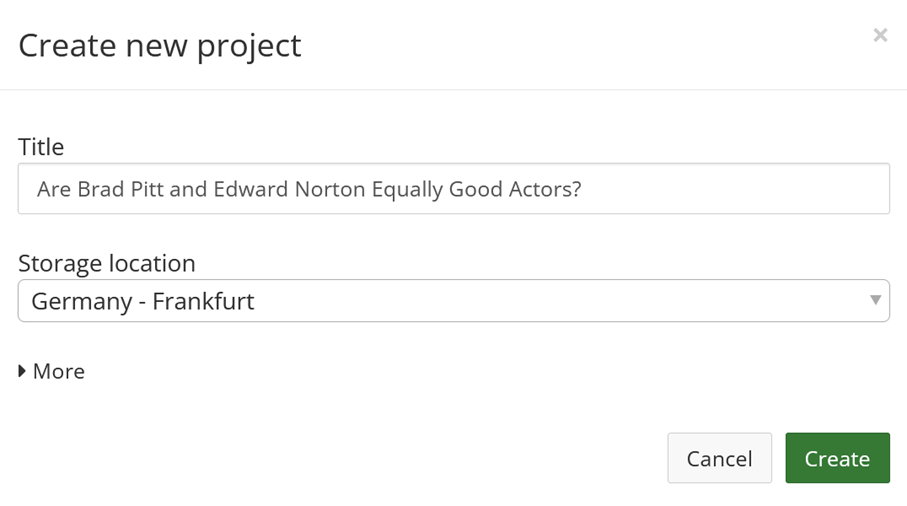
Añade una descripción para que otras personas entiendan de qué trata el proyecto y una licencia para que sepan cómo pueden reutilizar los materiales que compartas.
Puedes hacer público el proyecto inmediatamente o más adelante. Es habitual que los investigadores lo hagan público cuando se publica el artículo, pero si no te preocupa que otras personas reutilicen el contenido —y las ideas que contiene— puedes abrirlo desde el principio. Para ello, haz clic en el botón «Make public» situado en la parte superior derecha del proyecto.
Para prerregistrar un estudio, haz clic en «Registrations» en la barra superior y después en «new registration».
Recordatorio: no deberías utilizar OSF para prerregistrar simplemente con el objetivo de practicar. El sitio OSF Registries está concebido como una base de datos consultable de todos los registros y prerregistros científicos oficiales. Cuando completas un registro, permanecerá en OSF Registries para siempre y no existe forma de eliminarlo. Esto cuesta dinero y reduce la utilidad de la base de datos. Registra únicamente estudios reales.
Para investigaciones que contrastan hipótesis, la plantilla predeterminada de prerregistro de OSF ofrece una estructura útil. También permite subir archivos suplementarios, como el archivo HTML con la justificación del tamaño muestral que hemos elaborado anteriormente.
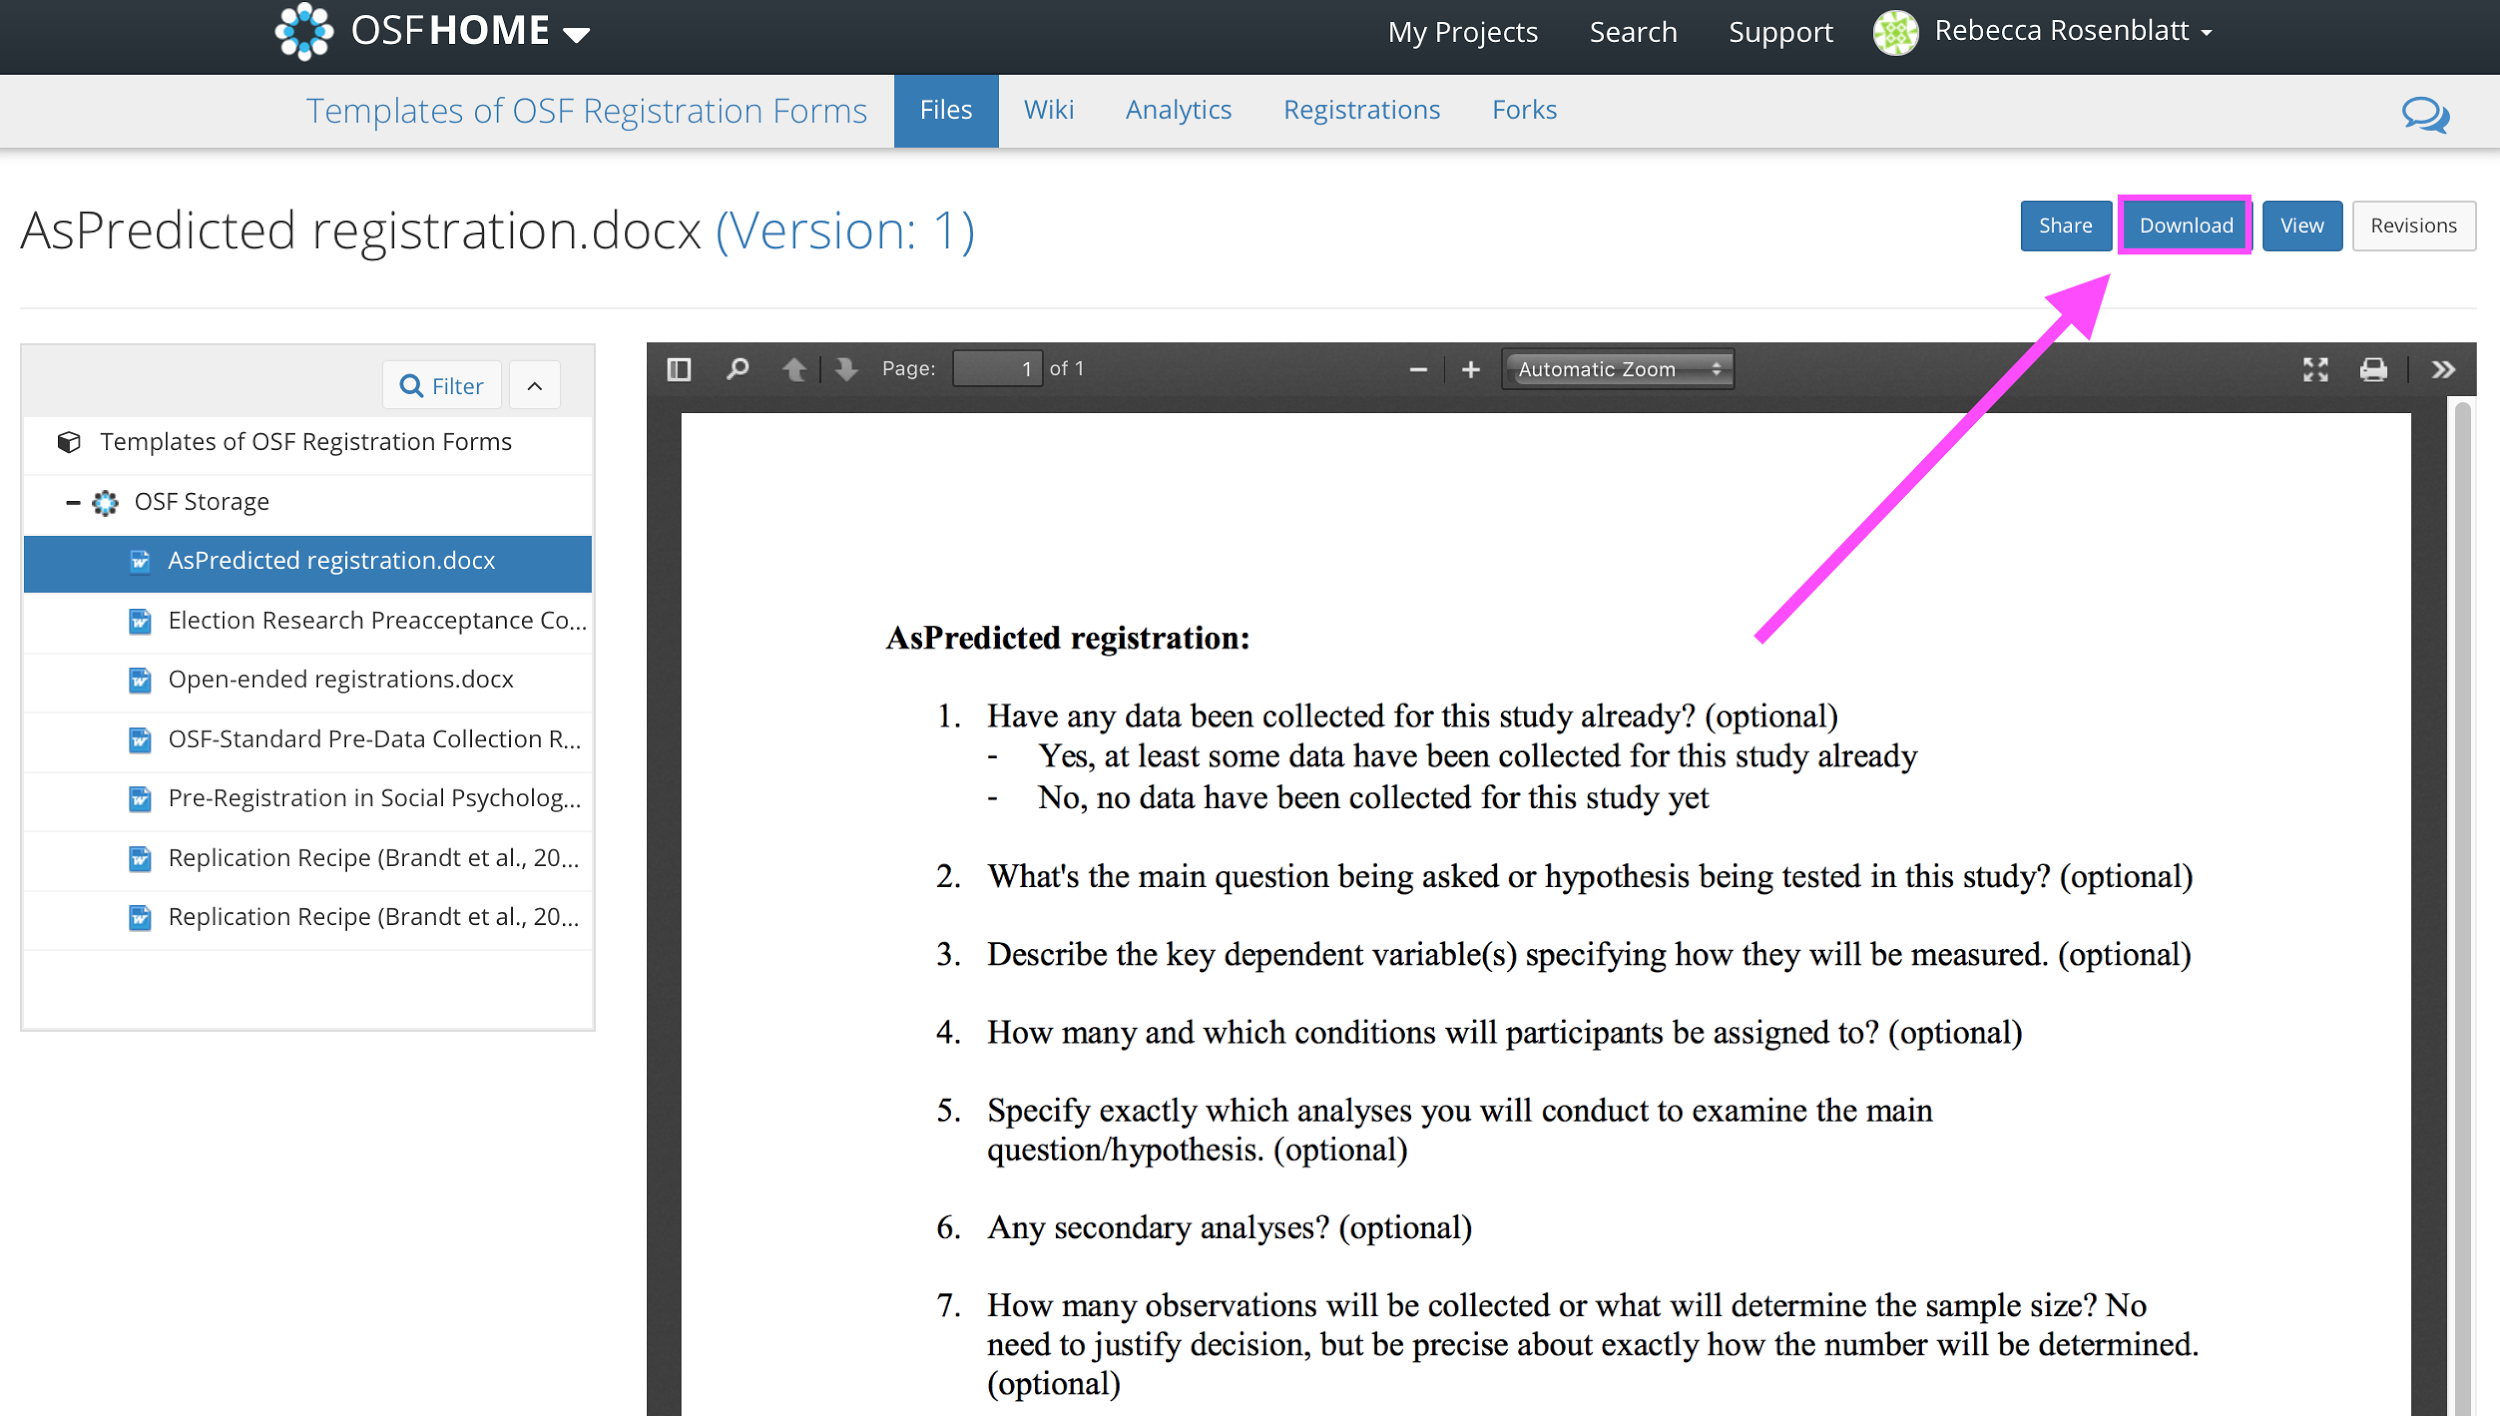
Se te planteará una serie de preguntas relevantes que deberás completar. Puedes consultar un prerregistro terminado relacionado con el estudio que compara las valoraciones de las películas protagonizadas por Brad Pitt y Edward Norton en https://doi.org/10.17605/OSF.IO/RJYCP. Ten en cuenta que todos los prerregistros de OSF se harán públicos después de cuatro años. Es la única de estas plataformas en la que no podrás mantener un prerregistro privado indefinidamente.
Para compartir el prerregistro durante el proceso de revisión, OSF permite crear un enlace de «solo lectura» (view-only link). Siempre que no hayas introducido información identificativa en ninguno de los archivos del proyecto, los revisores podrán consultar el prerregistro sin conocer tu identidad: https://help.osf.io/article/201-create-a-view-only-link-for-a-project.
13.8.4 Prerregistro en AsPredicted
AsPredicted ofrece un servicio de prerregistro centrado en la simplicidad. El sitio no permite prerregistros excesivamente largos. Normalmente esto se consigue eliminando del documento todas las justificaciones de las decisiones, lo que facilita la vida a quienes tienen que leer el prerregistro. AsPredicted se centra en distinguir la investigación exploratoria de la confirmatoria, pero, dado que no todas las desviaciones de un plan de análisis reducen la severidad de una prueba, considero importante asegurarse de que el límite de palabras no impida a los colegas evaluar si los cambios respecto al plan original aumentan o reducen la severidad de la prueba. Si consideras que el límite te restringe al redactar el prerregistro, puedes utilizar la plantilla de AsPredicted en OSF.
Ve a https://aspredicted.org/ y crea un nuevo prerregistro de AsPredicted haciendo clic en el botón «create». Introduce tu nombre, correo electrónico e institución.
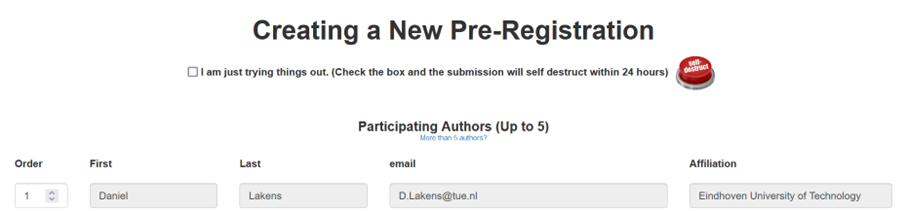
Desplázate hacia abajo y responde a las preguntas 1 a 11. En la pregunta 2 pega tu respuesta a P1; en la 3, tu respuesta a P2; en la 4 explica cuántos grupos compararás —por ejemplo, Edward Norton frente a Brad Pitt—; en las preguntas 5 y 6 introduce la respuesta a P4; y en la 7, la respuesta a P3. Responde a las preguntas restantes. Si quieres completar un prerregistro real para este ejercicio, indica en la pregunta 10 que estás utilizando AsPredicted para un «Class project or assignment».
Previsualiza el prerregistro y envíalo. Si has añadido coautores, deberán aprobar el envío. AsPredicted ofrece la posibilidad de crear un PDF anónimo para la revisión por pares o, alternativamente, hacer público el prerregistro.
Para compartir el prerregistro durante el proceso de revisión, AsPredicted permite descargar un PDF anónimo. Puedes ver el prerregistro correspondiente a la pregunta de investigación anterior en https://aspredicted.org/nx35m.pdf.