17 Estudios de replicación
Traducción literal al castellano del capítulo 17, «Replication Studies», de Daniël Lakens, Improving Your Statistical Inferences.
Original: https://lakens.github.io/statistical_inferences/17-replication.html
Licencia del original: CC-BY-4.0. Traducción no oficial.
En 2015, un equipo de 270 autores publicó los resultados de un proyecto de investigación en el que replicaron 100 estudios (Open Science Collaboration 2015). Todos los estudios originales habían sido publicados en tres revistas de psicología durante el año 2008. Los autores del proyecto de replicación seleccionaron el último estudio de cada artículo que fuera factible replicar, realizaron estudios con una potencia elevada para detectar el tamaño del efecto observado e intentaron diseñar la mejor replicación posible. Se mantuvieron tan cerca del estudio original como pudieron, aunque introdujeron cambios cuando consideraron que eran necesarios. De los 100 estudios originales publicados en 2008, 97 se habían interpretado como estadísticamente significativos. Dada una potencia estimada del 92 % para los tamaños del efecto observados en los estudios originales, cabría esperar que \(97 \times 0.92 = 89\) de las replicaciones observaran un efecto significativo si los efectos reales fueran al menos tan grandes como los comunicados. Sin embargo, solo 35 de los 97 estudios originalmente significativos se replicaron, lo que supone una tasa de replicación del 36 %. Este resultado sorprendió a la mayoría de los investigadores y llevó a reconocer que replicar hallazgos era mucho más difícil de lo que intuitivamente se pensaba. El resultado consolidó la idea de una crisis de replicación, es decir, una pérdida repentina de confianza en la fiabilidad de los resultados publicados que generó confusión e incertidumbre sobre la forma en que funcionaba la ciencia. Desde 2015 se ha desarrollado con fuerza el campo de la metaciencia, que utiliza métodos empíricos para estudiar la propia ciencia, identificar algunas de las causas de las bajas tasas de replicabilidad y desarrollar posibles soluciones para aumentarlas.
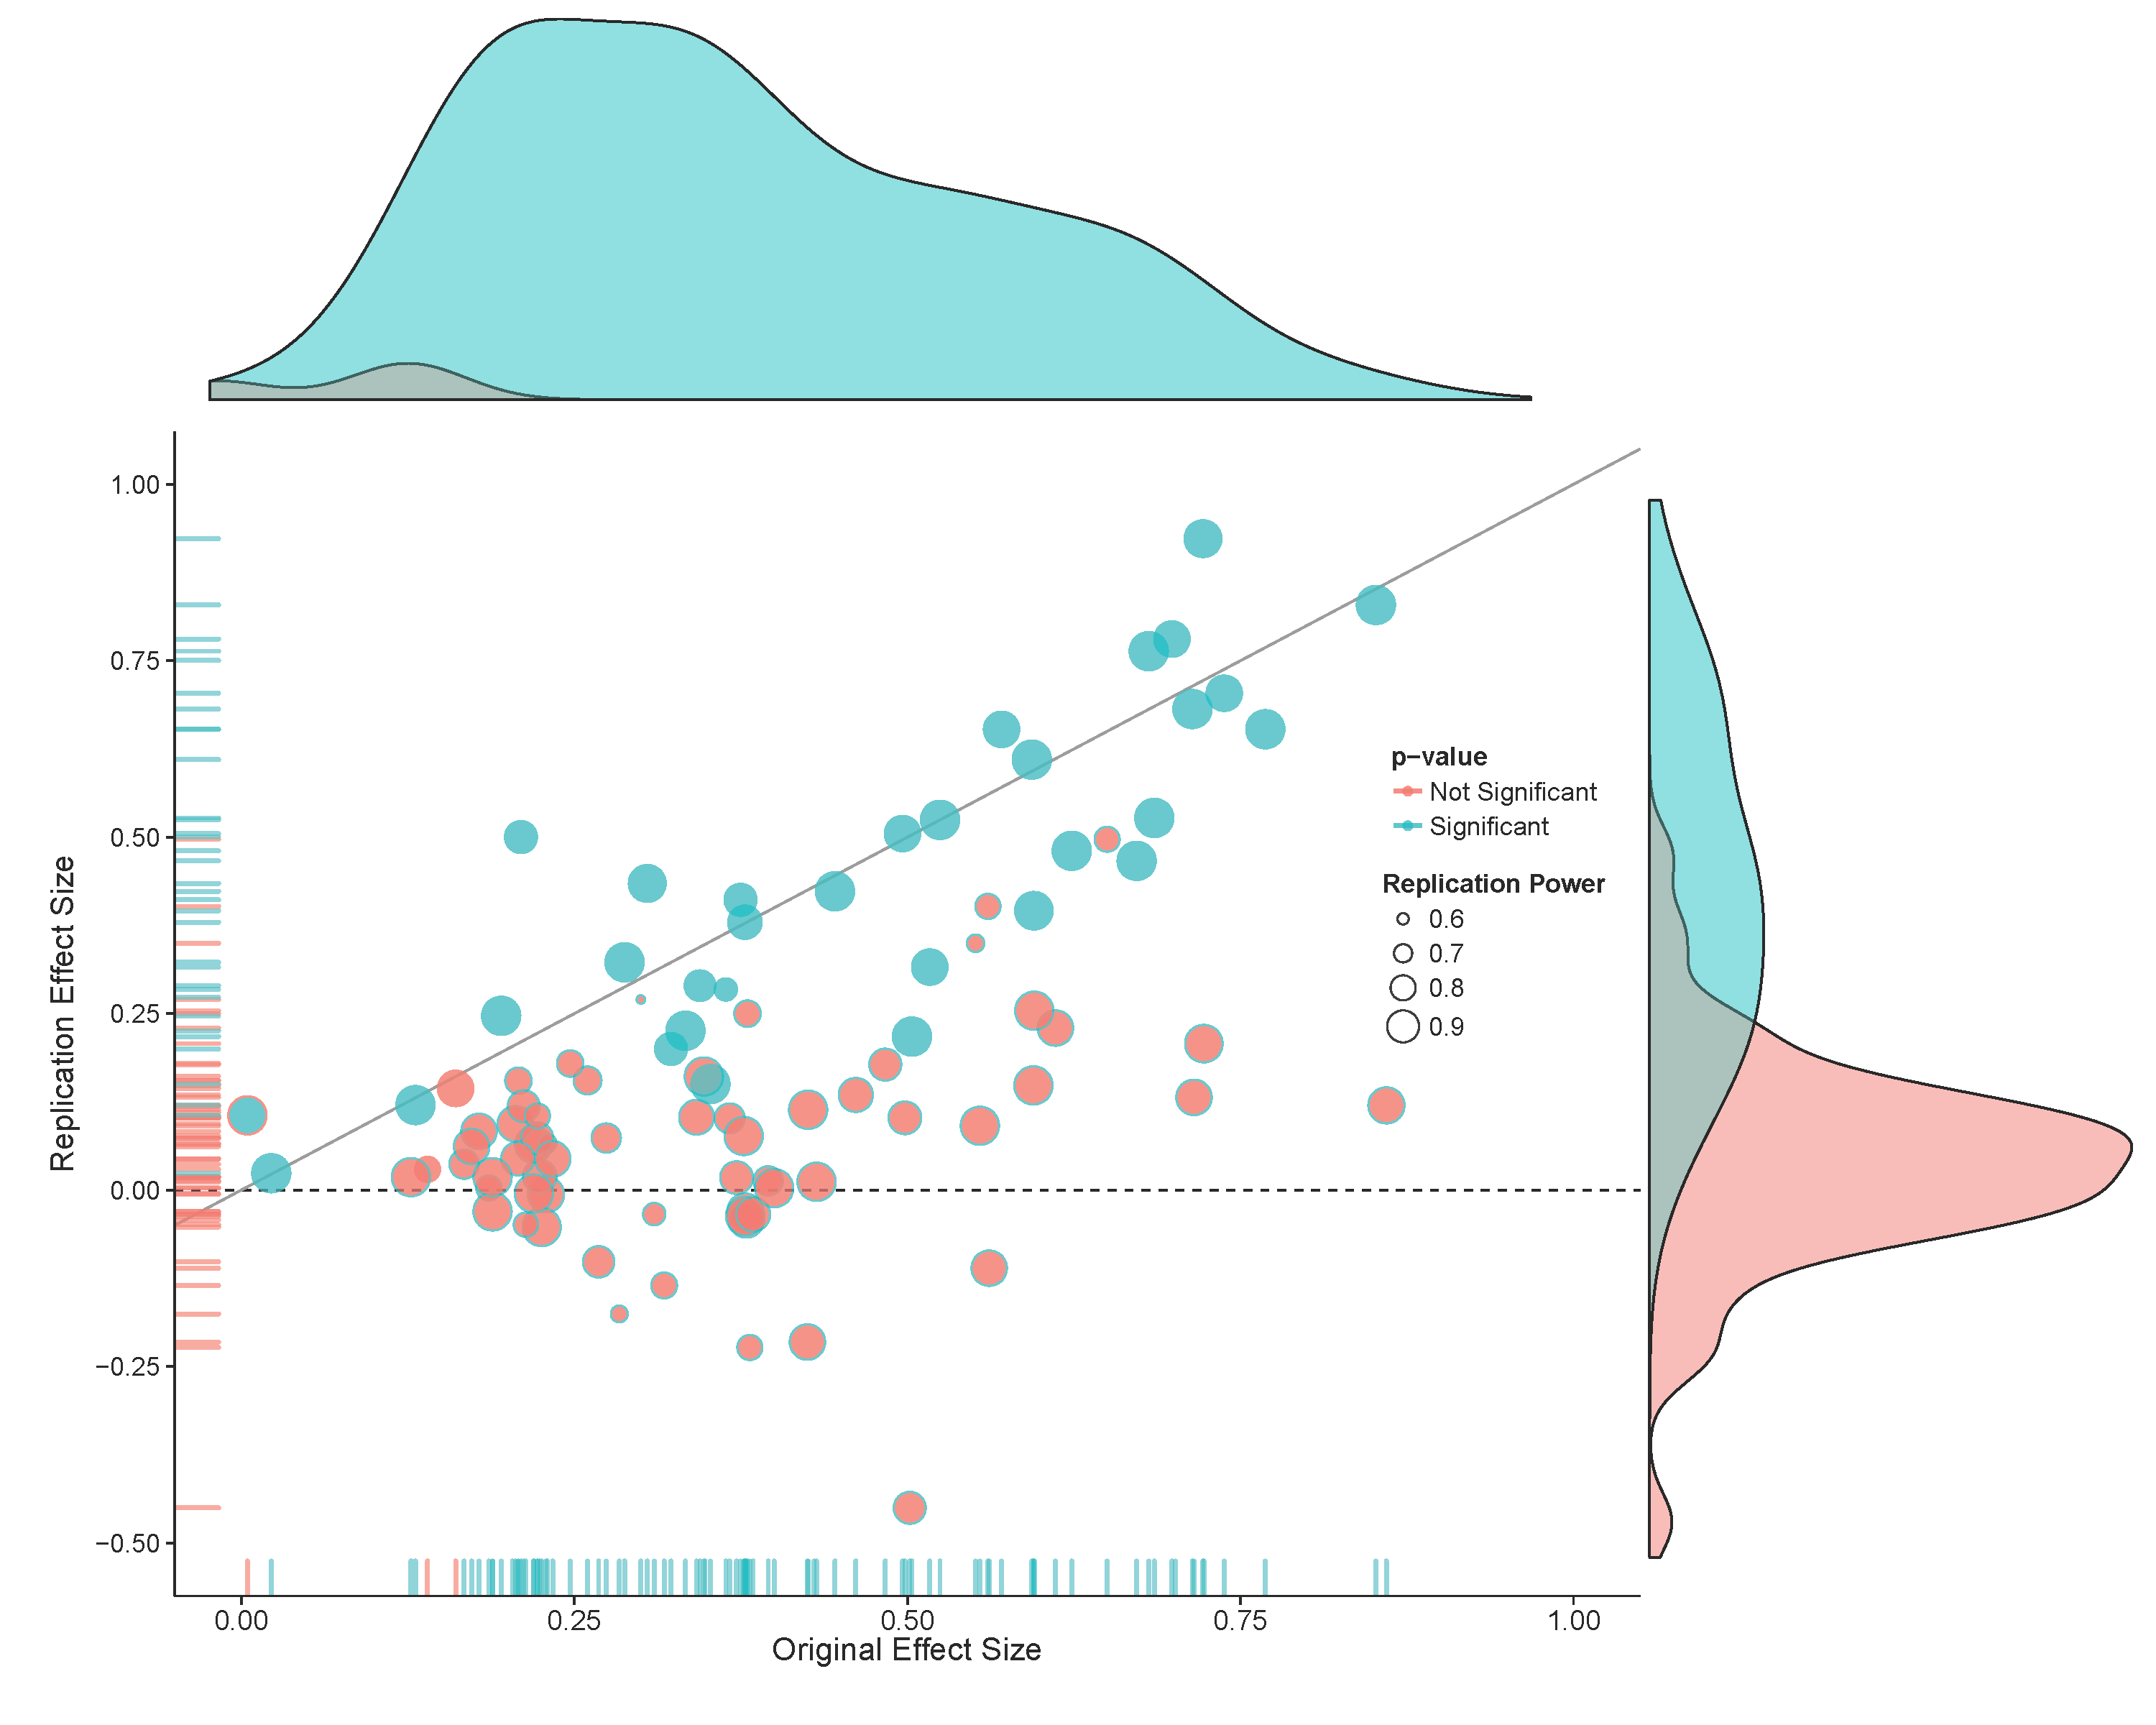
Al mismo tiempo, los autores del proyecto reconocieron que una única replicación de 100 estudios no era más que el punto de partida para comprender por qué había resultado tan difícil replicar los hallazgos de la literatura. En sus conclusiones escribieron:
Después de este intenso esfuerzo por reproducir una muestra de hallazgos psicológicos publicados, ¿cuántos de los efectos hemos establecido como verdaderos? Ninguno. ¿Y cuántos hemos establecido como falsos? Ninguno. ¿Es esto una limitación del diseño del proyecto? No. Es la realidad de hacer ciencia, aunque no siempre se reconozca en la práctica cotidiana. Los seres humanos deseamos certeza, y la ciencia rara vez la proporciona. Por mucho que quisiéramos que fuera de otro modo, un único estudio casi nunca ofrece una resolución definitiva a favor o en contra de un efecto y de su explicación. Los estudios originales examinados aquí proporcionaron evidencia tentativa; las replicaciones que realizamos proporcionaron evidencia confirmatoria adicional. En algunos casos, las replicaciones aumentan la confianza en la fiabilidad de los resultados originales; en otros, sugieren que se necesita más investigación para establecer la validez de los hallazgos originales. El progreso científico es un proceso acumulativo de reducción de la incertidumbre que solo puede tener éxito si la propia ciencia sigue siendo el mayor escéptico de sus afirmaciones explicativas.
Un estudio de replicación es un experimento en el que se repiten los métodos y procedimientos de un estudio anterior recogiendo datos nuevos. El término replicación directa suele utilizarse cuando los métodos y las medidas son tan similares como sea posible a los del estudio anterior. En una replicación conceptual, en cambio, el investigador introduce intencionadamente diferencias con respecto al estudio original con el objetivo de poner a prueba la generalización del efecto, bien porque quiere explorar sistemáticamente el impacto de ese cambio, bien porque no puede utilizar exactamente los mismos métodos y procedimientos.
Es importante distinguir la replicación, en la que se recogen datos nuevos, de la reproducibilidad, en la que se utilizan los mismos datos para reproducir los resultados comunicados. En las comprobaciones de reproducibilidad, el objetivo es examinar si existen errores en los archivos de análisis. De manera un tanto confusa, el gran proyecto colaborativo en el que se replicaron 100 estudios de psicología y que suele considerarse uno de los principales detonantes de la crisis de replicación se llamó Reproducibility Project: Psychology (Open Science Collaboration 2015). Habría sido más correcto llamarlo Replication Project: Psychology. Nuestras disculpas.
El primer objetivo de las replicaciones directas es identificar errores de tipo I o de tipo II en la literatura. En cualquier estudio original con un alfa del 5 % y una potencia estadística del 80 % existe cierta probabilidad de realizar una afirmación errónea. Las replicaciones directas —especialmente aquellas con tasas de error bajas— pretenden detectar esos errores en la literatura científica, algo esencial para construir una base de conocimiento fiable. Esto resulta especialmente importante porque la literatura científica está sesgada, lo que aumenta la probabilidad de que una afirmación publicada sea un error de tipo I. Schmidt (2009) señala además que las afirmaciones también pueden ser erróneas porque se basen en datos fraudulentos. Aunque una replicación directa no puede demostrar por sí sola que existió fraude, sí puede poner de manifiesto afirmaciones incorrectas producidas por datos fraudulentos.
El segundo objetivo importante de las replicaciones directas es identificar factores del estudio que se consideraban irrelevantes pero que fueron cruciales para generar los datos observados (Tunç y Tunç 2023). Por ejemplo, podría descubrirse que un estudio original y una replicación produjeron resultados diferentes porque el experimentador de uno de ellos trató a los participantes de una manera mucho más amistosa que el del otro. Este tipo de detalles normalmente no se incluyen en la sección de método porque se consideran irrelevantes, pero una replicación directa puede revelar que no lo eran. Esto pone de relieve que, en las ciencias sociales, dos estudios de replicación nunca son idénticos. Se diseñan para ser similares en todos aquellos aspectos que el investigador piensa que importan. Sin embargo, no todos los factores considerados irrelevantes lo serán realmente —y viceversa—.
El objetivo de las replicaciones conceptuales es examinar la generalizabilidad de los efectos (Sidman 1960). Los investigadores varían intencionadamente ciertos factores del experimento para comprobar si ello introduce variabilidad en los resultados. En ocasiones esa variabilidad está predicha por la teoría; en otras, simplemente se desea observar qué sucede. Yo definiría una replicación directa como un estudio en el que el investigador intenta no introducir variabilidad en el tamaño del efecto con respecto al estudio original, mientras que en una replicación conceptual se introduce variabilidad de forma intencionada para poner a prueba la generalización del efecto.
Esta distinción implica que un estudio que un investigador considera una replicación directa puede ser visto por otro como una replicación conceptual. Si alguien no encuentra ninguna razón por la que un efecto estudiado en Alemania deba ser distinto en los Países Bajos, considerará una repetición neerlandesa como una replicación directa. Otro investigador puede pensar que existen diferencias teóricamente relevantes entre ambos países y considerarla conceptual, porque interpretará que se ha introducido variabilidad al no mantener constante un factor importante. La única forma de aclarar qué factores se consideran teóricamente relevantes consiste en incluir en la discusión una declaración de restricciones a la generalización, especificando en qué contextos se espera teóricamente que el efecto se replique y en cuáles una variación de los resultados no constituiría un problema para la afirmación original (Simons et al. 2017).
Debe quedar claro que los objetivos de los estudios de replicación son bastante modestos. Al mismo tiempo, son esenciales para que una ciencia empírica funcione adecuadamente. Proporcionan una herramienta para identificar falsos positivos y falsos negativos, y pueden revelar variabilidad entre contextos que falsifique predicciones teóricas o conduzca al desarrollo de teorías nuevas. Ser capaz de replicar y extender de forma sistemática un efecto básico es una de las maneras más importantes en que los científicos desarrollan y ponen a prueba teorías. Aunque existen otras estrategias para generar conocimiento fiable, como la triangulación, en la que una misma teoría se contrasta de maneras diferentes pero complementarias, en la práctica la inmensa mayoría de las afirmaciones científicas consolidadas se apoyan en efectos replicables.
No todos los investigadores aceptan que su ciencia estudie observaciones repetibles intersubjetivamente. En lo que se denominó la «crisis de la psicología social», Gergen (1973) sostuvo que la psicología social no era una ciencia acumulativa:
El propósito de este artículo es sostener que la psicología social es, fundamentalmente, una investigación histórica. A diferencia de las ciencias naturales, trata con hechos que son en gran medida irrepetibles y que fluctúan notablemente con el tiempo. Los principios de la interacción humana no pueden desarrollarse fácilmente a lo largo del tiempo porque los hechos en los que se basan no suelen permanecer estables. El conocimiento no puede acumularse en el sentido científico habitual porque, en general, no trasciende sus límites históricos.
La creencia de que las afirmaciones básicas de la psicología no describen acontecimientos repetibles dio lugar al constructivismo social. Este enfoque no llegó a hacerse especialmente popular, pero es útil conocer su existencia. Es un hecho que la conducta humana puede cambiar con el tiempo. También es cierto que muchos mecanismos psicológicos han permitido realizar predicciones acertadas durante más de un siglo, y es poco probable que esto cambie. Aun así, algunos investigadores pueden considerar que estudian acontecimientos irrepetibles; si es así, deberían explicar por qué. Estos investigadores renuncian al objetivo de construir teorías capaces de generar predicciones generalizables y tendrán que ofrecer otros argumentos para justificar el valor de su investigación.
Afortunadamente, no hace falta ser constructivista social para reconocer que el mundo cambia. No deberíamos esperar que todas las replicaciones directas produzjeran exactamente el mismo resultado. Por ejemplo, en el clásico estudio del efecto de pie en la puerta, Freedman y Fraser (1966) llamaron primero por teléfono a residentes de una comunidad para pedirles que respondieran algunas preguntas —la petición pequeña—. Si aceptaban, se les formulaba después una petición mucho mayor: permitir que «cinco o seis hombres de nuestro personal entren en su casa una mañana durante unas dos horas para enumerar y clasificar todos los productos domésticos que tienen. Tendrán que disponer de total libertad en su casa para revisar armarios y lugares de almacenamiento». Parece muy improbable que hoy más de la mitad de las personas aceptaran una petición semejante procedente de un desconocido que llama por teléfono. Repetir literalmente el procedimiento ya no produciría el mismo resultado. Pero las teorías que construimos deberían ser capaces de explicar por qué algunos hallazgos dejan de replicarse, especificando qué condiciones son necesarias para que el efecto aparezca. Esa es precisamente la función de la teoría. Si disponemos de buenas teorías, deberíamos poder seguir haciendo predicciones aunque algunos aspectos del mundo cambien. Como escribe De Groot (1969, 89): «Si uno sabe que algo es verdadero, está en condiciones de predecir; donde la predicción es imposible no hay conocimiento».
17.1 Por qué son importantes los estudios de replicación
Durante el último medio siglo, los investigadores han señalado repetidamente que los estudios de replicación se realizan y publican muy pocas veces. En un editorial del Journal of Personality and Social Psychology, Greenwald (Greenwald 1976) escribió: «Puede existir una crisis en la psicología de la personalidad y social asociada a la dificultad que con frecuencia experimentan los investigadores al intentar replicar trabajos publicados. No puede realizarse una estimación precisa de la magnitud de este problema porque la mayoría de los fracasos de replicación no se comunican públicamente». Epstein (Epstein 1980, 790) expresó una preocupación similar: «Los hallazgos experimentales no solo son a menudo difíciles de replicar cuando se introducen las más pequeñas modificaciones en las condiciones, sino que incluso los intentos de replicación exacta fracasan con frecuencia».
Neher (1967, 262) concluyó: «La adopción general de la replicación independiente como requisito para aceptar hallazgos en las ciencias de la conducta requerirá el esfuerzo conjunto de investigadores, lectores y editores. Parece claro que una política de este tipo llega con mucho retraso y es crucial para desarrollar un cuerpo sólido de conocimiento sobre la conducta humana». Lubin (Lubin 1957) propuso que, cuando fuera relevante, los manuscritos que demostraran la replicabilidad de los hallazgos recibieran mayor prioridad de publicación. N. C. Smith (1970, 974) señaló el abandono de la replicación: «La revisión de la literatura sobre replicación y validación cruzada revela que los psicólogos de ambas “disciplinas” de investigación han tendido a ignorar la investigación de replicación. Por ello, uno no puede evitar preguntarse qué ocurriría si cada investigador repitiera el estudio que considera su contribución más importante al campo».
Un problema histórico era la dificultad de describir los métodos y análisis con suficiente detalle como para que otras personas pudieran repetir el estudio tan fielmente como fuera posible (Mack 1951). Pereboom (1971, 442) escribió: «Relacionado con lo anterior está la dificultad habitual de comunicar a la audiencia todos los detalles importantes de un experimento psicológico. […] Los investigadores que intentan replicar el trabajo de otros son dolorosamente conscientes de estas lagunas de información». Las prácticas de ciencia abierta, como compartir código y materiales computacionalmente reproducibles, constituyen una forma importante de solucionar este problema, y durante la última década se ha avanzado mucho en esta dirección.
Muchos investigadores han defendido que realizar replicaciones debería ser una práctica habitual. Lykken (1968, 159) escribió: «Idealmente, todos los experimentos se replicarían antes de su publicación, pero este objetivo no es práctico». Loevinger (1968, 455) hizo una observación similar: «La mayoría de los estudios deberían replicarse antes de publicarse. Esta recomendación es especialmente pertinente cuando los resultados van en la dirección predicha pero no son significativos, son apenas significativos o solo lo son mediante pruebas unilaterales». Samelson (1980, 623), en el contexto específico del estudio del «pequeño Albert» de Watson, señaló: «Más allá de este aparente fracaso de la crítica interna de los datos existe otro todavía menos discutible: el claro abandono de una regla cardinal del método científico, a saber, la replicación».
La idea de que la replicación es una «regla cardinal» o una «piedra angular» del método científico se deriva directamente de una filosofía de la ciencia falsacionista metodológica. Popper (2002) explicó que aumentamos nuestra confianza en las teorías cuyas predicciones resisten los intentos de falsarlas. Para que una predicción pueda falsarse, debe excluir determinados patrones de datos observables. Si nuestra teoría predice que las personas serán más rápidas nombrando el color de una palabra cuando su significado coincida con el color en que está escrita —por ejemplo, «azul» escrito en azul en lugar de «azul» escrito en rojo—, observar que no son más rápidas, o incluso que son más lentas, falsaría la predicción.
El problema es que, debido a la variabilidad de los datos observados, cualquier patrón posible aparecerá alguna vez, exactamente con la frecuencia que dicte el azar. A largo plazo, por puro azar, algún estudio mostrará que las personas son más lentas al nombrar el color cuando palabra y color coinciden, aunque la teoría sea correcta. Popper vio que esto planteaba un problema para su explicación de la falsación, porque significa que «los enunciados probabilísticos no serán falsables». Si todos los patrones de datos posibles tienen una probabilidad distinta de cero, aunque algunos sean extremadamente raros, ninguno queda lógicamente excluido. Si exigiéramos que la ciencia siguiera reglas lógicas perfectamente formales, esto haría imposible la falsación.
La solución consiste en reconocer que la ciencia no funciona mediante reglas perfectamente formales. Y, sin embargo, como admitía Popper, funciona. Por tanto, en lugar de abandonar la falsación, propuso un enfoque más pragmático: «Parece bastante claro que esta “falsación práctica” solo puede lograrse mediante una decisión metodológica de considerar excluidos —prohibidos— los acontecimientos altamente improbables». La pregunta lógica es entonces: «¿Dónde trazamos la línea? ¿Dónde comienza esa “alta improbabilidad”?». Popper argumenta que, aunque cualquier acontecimiento de baja probabilidad puede ocurrir, no puede reproducirse a voluntad. Un único estudio puede revelar prácticamente cualquier efecto posible, pero una predicción debería considerarse falsada cuando no observamos «la aparición predecible y reproducible de desviaciones sistemáticas». Esta es la razón por la que la replicación constituye una «regla cardinal» en el falsacionismo metodológico: cuando las observaciones son probabilísticas, solo la aparición replicable de acontecimientos de baja probabilidad puede tomarse como falsación de una predicción. Un único p < .05 no basta; Popper solo permite «falsar prácticamente» una predicción probabilística cuando replicaciones cercanas observan repetidamente un acontecimiento improbable.
17.2 Replicaciones directas frente a conceptuales
Como escribe Schmidt (2009), «no existe algo así como una replicación exacta». Sin embargo, podemos: 1) repetir un experimento manteniéndonos tan cerca como sea posible del estudio original; 2) repetirlo introduciendo probablemente alguna variación en factores que se consideran irrelevantes; o 3) variar deliberadamente aspectos del diseño. Popper coincide: «Nunca podemos repetir un experimento con total precisión; todo lo que podemos hacer es mantener determinadas condiciones constantes dentro de ciertos límites».
Uno de los primeros tratamientos extensos de la replicación procede de Sidman (1960), quien distingue las replicaciones directas de las replicaciones sistemáticas —que aquí denomino replicaciones conceptuales—:
Mientras que la replicación directa ayuda a establecer la generalidad de un fenómeno entre los miembros de una especie, la replicación sistemática puede conseguir esto mismo y, al mismo tiempo, extender su generalidad a un amplio conjunto de situaciones diferentes.
Si observamos el mismo resultado al variar sistemáticamente las hipótesis auxiliares, aumenta nuestra confianza en la naturaleza general del hallazgo y, por tanto, en el propio hallazgo. Cuanto más robusto sea un efecto frente a factores considerados irrelevantes, menos probable resulta que esté causado por un factor de confusión introducido por alguno de ellos. Si una predicción se confirma a lo largo del tiempo, en distintas localizaciones, con muestras diferentes, por distintos experimentadores y mediante distintas medidas de la misma variable, disminuye la probabilidad de que todos esos efectos estén causados por el mismo confusor. Cuando una replicación conceptual tiene éxito, aporta más información que una directa porque generaliza el hallazgo más allá del contexto original. Sin embargo, esta ventaja solo existe cuando la replicación conceptual tiene éxito. Sidman advierte:
Pero este procedimiento es una apuesta. Si la replicación sistemática fracasa, todavía será necesario repetir el experimento original; de lo contrario, no habrá forma de determinar si el fracaso se debió a las nuevas variables introducidas en el segundo experimento o a que el primer experimento no controló adecuadamente los factores relevantes.
A veces no es necesario elegir entre una replicación directa y una conceptual porque pueden realizarse ambas. Los investigadores pueden llevar a cabo estudios de replicación y extensión, en los que se replica el estudio original y se añaden condiciones que ponen a prueba hipótesis nuevas. Sidman (1960) se refiere a esta estrategia como técnica de línea base: el efecto original forma siempre parte del diseño experimental y las variaciones se comparan con él. Los estudios de replicación y extensión constituyen una de las mejores formas de construir conocimiento acumulativo y desarrollar teorías científicas sólidas (Bonett 2012).
A menudo resulta difícil llegar a un acuerdo sobre si un estudio es una replicación directa o conceptual, porque los investigadores pueden discrepar acerca de si ciertos cambios son teóricamente relevantes. Algunos autores han intentado resolver esta dificultad definiendo una replicación como «un estudio para el cual cualquier resultado se consideraría evidencia diagnóstica sobre una afirmación de una investigación previa» (Nosek y Errington 2020). Sin embargo, esta definición es demasiado amplia para resultar útil en la práctica. Tiene una utilidad limitada cuando las predicciones teóricas son vagas —lo que, lamentablemente, ocurre en muchas líneas de investigación en psicología— y no reconoce suficientemente la importancia de especificar hipótesis auxiliares falsables.
La especificación de hipótesis auxiliares falsables en las replicaciones está en el núcleo del Systematic Replications Framework (Tunç y Tunç 2023). La idea es que los investigadores deben indicar qué hipótesis auxiliares consideran relevantes. En principio, su número es infinito, pero Uygun-Tunç y Tunç (2023) señalan que normalmente se asume que «el color exacto de las paredes del laboratorio, su altitud sobre el nivel del mar, el diseño preciso de las sillas utilizadas por los participantes, la humedad de la sala o muchos otros detalles minúsculos no influyen de manera significativa en los resultados». Estos factores quedan relegados a la cláusula ceteris paribus: sus diferencias no se consideran relevantes y, a efectos prácticos, los estudios pueden tratarse como «iguales en todo lo demás», aunque las paredes tengan colores distintos.
Ninguna replicación es exactamente igual al estudio original (Schmidt 2009), y algunas diferencias entre hipótesis auxiliares sí son sustantivamente importantes. El desafío consiste en identificar qué hipótesis auxiliares explican los fracasos de replicación. Una replicación directa que no produce un efecto estadísticamente significativo puede tener tres interpretaciones (Schmidt 2009; Tunç y Tunç 2023): primero, la replicación puede haber producido un error de tipo II; segundo, el estudio original puede haber sido un error de tipo I; tercero, alguna de las suposiciones auxiliares relegadas a la cláusula ceteris paribus puede importar más de lo que se creía.
Para resolver desacuerdos entre el estudio original y la replicación deberían realizarse estudios que varíen sistemáticamente aquellas hipótesis auxiliares que sean más cruciales para cada posición teórica. Resolver inconsistencias científicas es un proceso laborioso que puede facilitarse mediante una colaboración adversarial, en la que dos equipos unen fuerzas para resolver el desacuerdo (Mellers et al. 2001). Los equipos enfrentados pueden identificar las hipótesis auxiliares decisivas y someter las teorías rivales a pruebas severas.
17.3 Análisis de los estudios de replicación
Existen múltiples formas de analizar estadísticamente una replicación (Anderson y Maxwell 2016). El enfoque estadístico más directo es también uno de los menos utilizados: comprobar si los tamaños del efecto del estudio original y de la replicación son estadísticamente diferentes. Dos tamaños del efecto procedentes de pruebas t independientes pueden compararse mediante:
\[ Z_\mathrm{Diff} = \frac{\delta_1 - \delta_2}{\sqrt{V_{\delta_1} + V_{\delta_2}}} \]
donde la diferencia entre los dos tamaños del efecto de Cohen, \(d\), se divide por el error estándar de la diferencia, calculado a partir de la raíz cuadrada de las varianzas combinadas de los tamaños del efecto (Borenstein 2009, fórmulas 19.6 y 19.7). La fórmula ofrece una pista de por qué los investigadores rara vez ponen a prueba directamente las diferencias entre tamaños del efecto: el error estándar depende de la varianza tanto del estudio original como de la replicación. Si el estudio original tiene una muestra pequeña, su varianza será grande y la prueba de la diferencia puede tener una potencia muy baja.
Consideremos un estudio original no prerregistrado que observó \(d = 0.6\) en una prueba t independiente con 30 participantes en cada grupo. Se realiza después una replicación prerregistrada que observa \(d = 0\) con 100 participantes por grupo. La comparación puede hacerse de tres maneras que, en principio, son equivalentes —aunque detalles de implementación como utilizar \(d\) de Cohen o \(g\) de Hedges pueden generar valores p ligeramente distintos—. La primera consiste en calcular el valor p de la prueba \(Z\) anterior. Las otras dos se implementan en el paquete metafor: un análisis de heterogeneidad y un análisis de moderación. Ambos son matemáticamente equivalentes. En el análisis de heterogeneidad comprobamos si la variabilidad entre los tamaños del efecto —aunque solo haya dos— es mayor que la esperable por variación aleatoria.
d1 <- escalc(n1i = 30,
             n2i = 30,
             di = 0.6,
             measure = "SMD")
d2 <- escalc(n1i = 100,
             n2i = 100,
             di = 0.0,
             measure = "SMD")
metadata <- data.frame(yi = c(d1$yi, d2$yi),
                       vi = c(d1$vi, d2$vi),
                       study = c("original", "replication"))

# Prueba basada en el análisis de heterogeneidad
res_h <- rma(yi,
             vi,
             data = metadata,
             method = "FE")
res_h
Fixed-Effects Model (k = 2)
I^2 (total heterogeneity / total variability): 74.45%
H^2 (total variability / sampling variability): 3.91
Test for Heterogeneity:
Q(df = 1) = 3.9146, p-val = 0.0479
Model Results:
estimate se zval pval ci.lb ci.ub
0.1322 0.1246 1.0607 0.2888 -0.1121 0.3765El resultado produce un valor p de 0.048, estadísticamente significativo, por lo que podemos concluir estadísticamente que ambos tamaños del efecto difieren. También puede realizarse la misma prueba mediante un análisis de moderación:
res_mod <- rma(yi,
               vi,
               mods = ~study,
               method = "FE",
               data = metadata,
               digits = 3)
El resultado produce el mismo valor p, 0.048. Spence y Stanley (2024) han vuelto a presentar recientemente esta misma prueba en forma de intervalo de predicción, pero en esencia sigue siendo una prueba de la diferencia entre los tamaños del efecto.
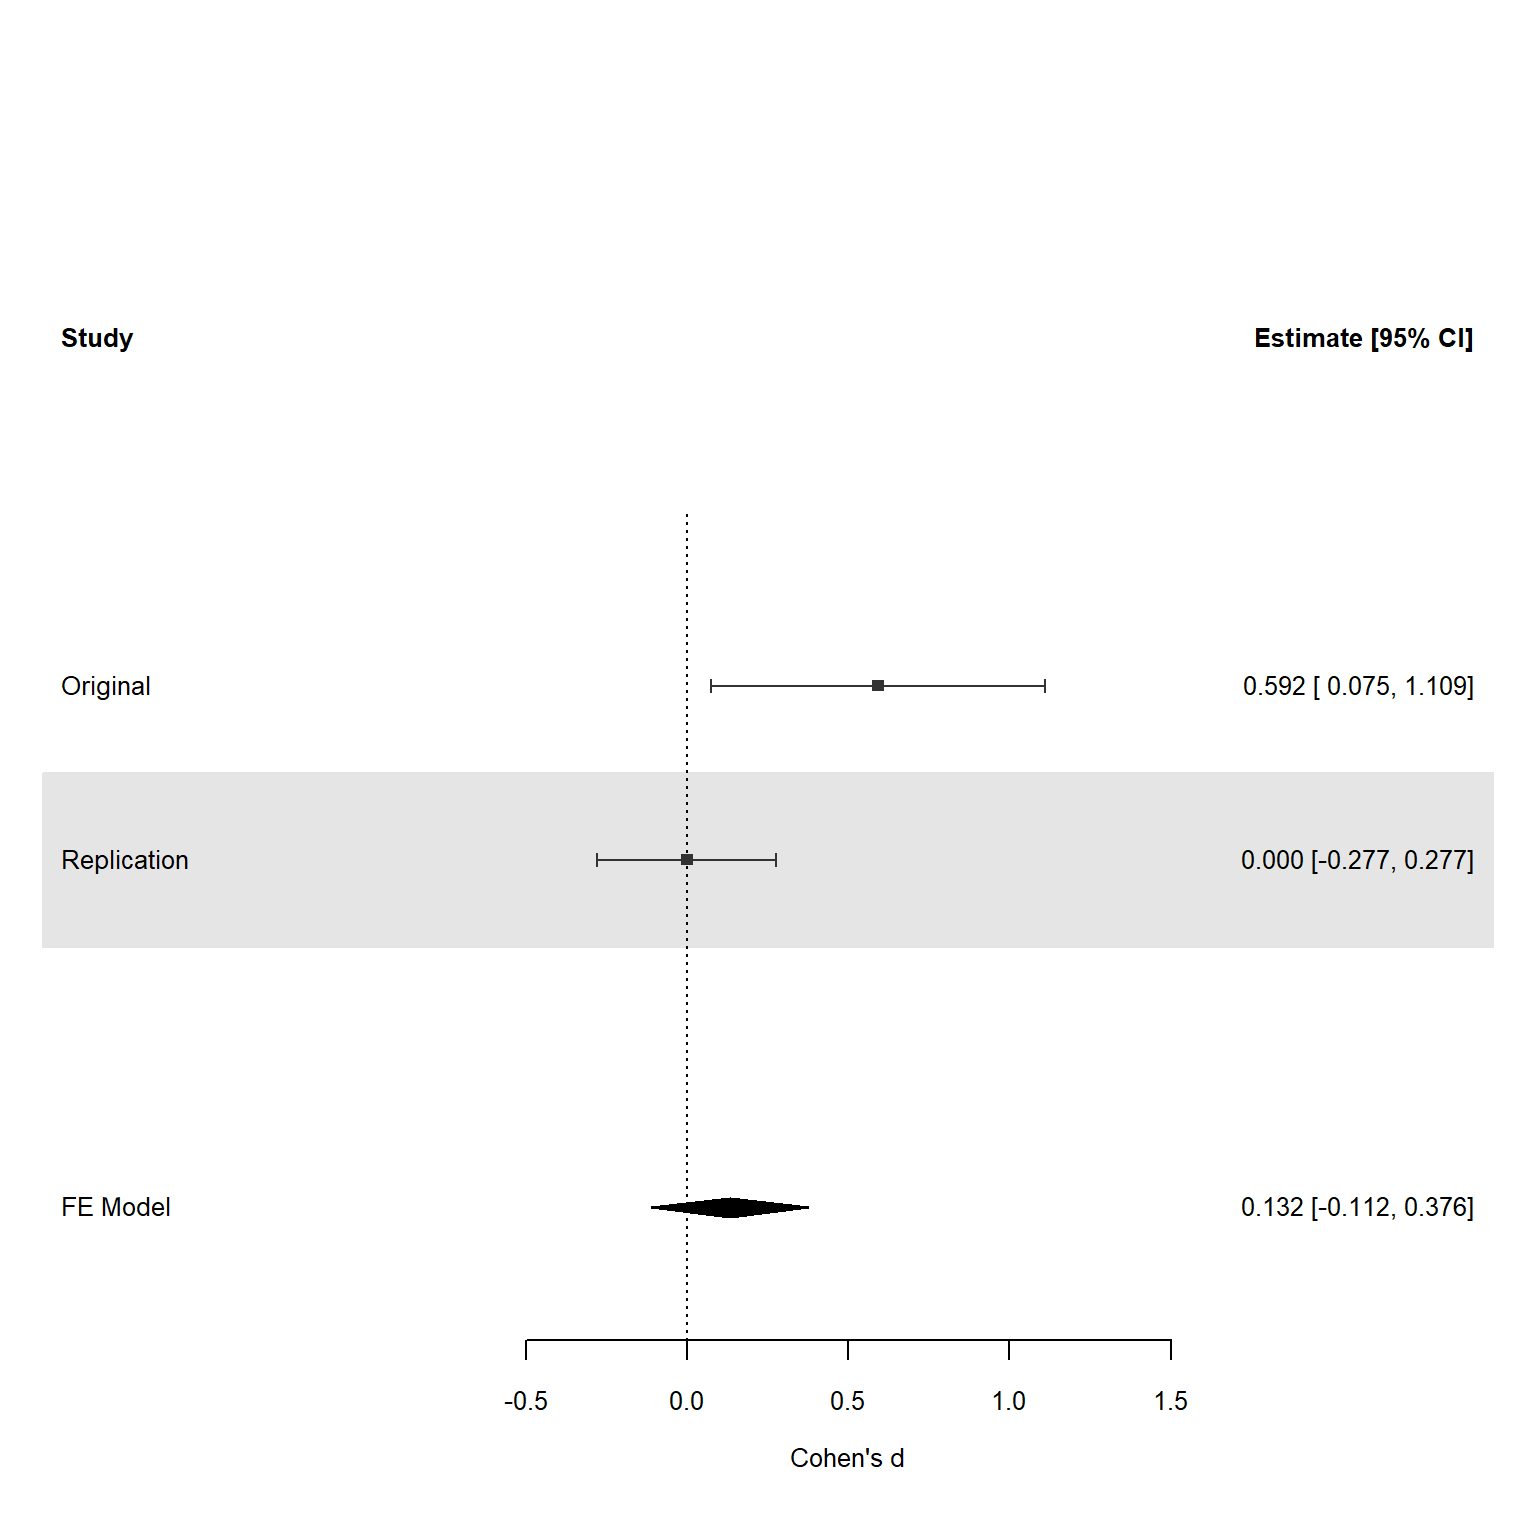
Conviene observar que en este ejemplo la diferencia entre ambos tamaños del efecto es grande y que la replicación tiene una muestra mucho mayor que el estudio original, pero aun así la diferencia apenas alcanza la significación estadística. Como muestra la Figura 17.2, el estudio original posee una incertidumbre considerable, que forma parte de la varianza del estimador de la diferencia. Si la replicación hubiera producido un tamaño del efecto incluso ligeramente positivo —algo que ocurriría aproximadamente el 50 % de las veces si el efecto verdadero fuera cero—, la diferencia ya no habría sido estadísticamente significativa. En general, la potencia es baja cuando los estudios originales tienen muestras pequeñas. A pesar de esta limitación, comparar directamente ambos tamaños del efecto es la forma más intuitiva y coherente de afirmar que un estudio no se ha replicado.
También es posible contrastar la diferencia entre dos correlaciones mediante:
\[ z_1 = \frac{1}{2}\ln\left(\frac{1+r_1}{1-r_1}\right), \quad z_2 = \frac{1}{2}\ln\left(\frac{1+r_2}{1-r_2}\right) \]
\[ Z = \frac{z_1 - z_2}{\sqrt{\frac{1}{n_1 - 3} + \frac{1}{n_2 - 3}}} \]
Por ejemplo, la prueba puede realizarse con el paquete cocor de R:
library(cocor)
cocor.indep.groups(n1 = 20, r1.jk = .6, n2 = 25, r2.hm = .8)
Results of a comparison of two correlations based on independent groups
Comparison between r1.jk = 0.6 and r2.hm = 0.8
Difference: r1.jk - r2.hm = -0.2
Group sizes: n1 = 20, n2 = 25
Null hypothesis: r1.jk is equal to r2.hm
Alternative hypothesis: r1.jk is not equal to r2.hm (two-sided)
Alpha: 0.05
fisher1925: Fisher's z (1925)
z = -1.2556, p-value = 0.2093
Null hypothesis retained
zou2007: Zou's (2007) confidence interval
95% confidence interval for r1.jk - r2.hm: -0.6005 0.1055
Null hypothesis retained (Interval includes 0)Fisher (Fisher 1925) proporciona un ejemplo para comprobar si dos correlaciones son estadísticamente distintas. La primera es \(r = 0.6\) con 20 pares y la segunda \(r = 0.8\) con 25 pares. Para contrastar su diferencia, ambas correlaciones se transforman a puntuaciones \(z\) mediante la transformación \(z\) de Fisher:
\[ z_1 = \frac{1}{2}\ln\left(\frac{1+r_1}{1-r_1}\right) = \frac{1}{2}\ln\left(\frac{1+0.6}{1-0.6}\right) = 0.6931 \]
\[ z_2 = \frac{1}{2}\ln\left(\frac{1+r_2}{1-r_2}\right) = \frac{1}{2}\ln\left(\frac{1+0.8}{1-0.8}\right) = 1.0986 \]
La desviación estándar de la diferencia es:
\[ \sigma_{z_1-z_2} = \sqrt{\frac{1}{n_1-3}+\frac{1}{n_2-3}} = \sqrt{\frac{1}{20-3}+\frac{1}{25-3}} = 0.3229 \]
y, finalmente, el estadístico bajo la hipótesis nula:
\[ z = \frac{z_1-z_2}{\sigma_{z_1-z_2}} = \frac{0.6931-1.0986}{0.3229} = \frac{-0.4055}{0.3229} = -1.256 \]
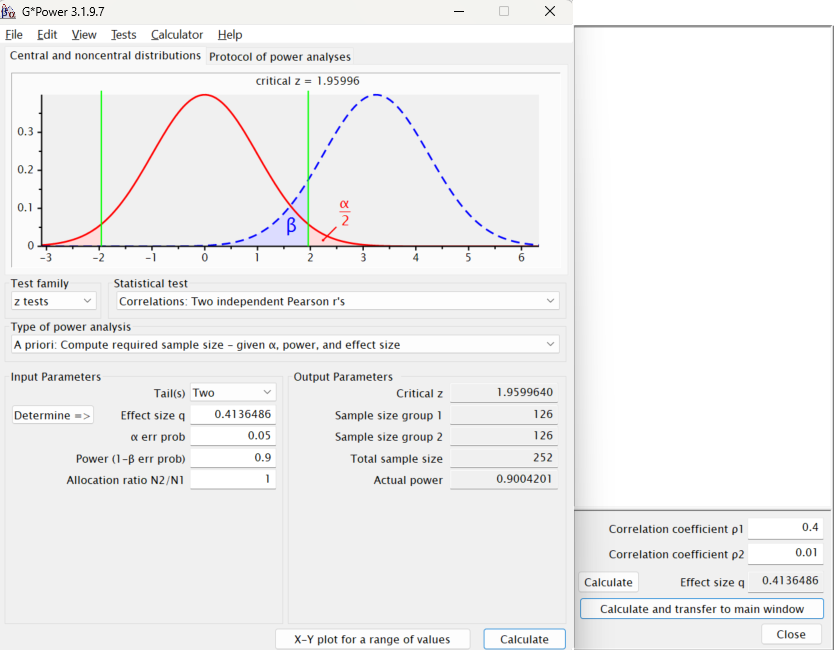
El estadístico \(z = -1.256\) corresponde a un valor p bilateral de .209, por lo que la diferencia no es estadísticamente significativa con \(\alpha = 0.05\). Podemos utilizar el paquete pwrss (Bulus y Polat 2023) para calcular el tamaño muestral necesario para detectar una diferencia como esta con una potencia del 90 %:
library(pwrss)
pwrss.z.2corrs(r1 = 0.6, r2 = 0.8,
               power = .90, alpha = 0.05,
               alternative = "not equal")
Sample Size = 131 and 131
Type 1 Error (alpha) = 0.050
Type 2 Error (beta) = 0.100
Statistical Power = 0.9El mismo cálculo puede realizarse en G*Power.
Aunque comprobar una diferencia estadística entre tamaños del efecto constituye una forma coherente de decidir si un estudio se ha replicado, en ocasiones los investigadores plantean otra pregunta: ¿hubo un resultado significativo en la replicación? Con este enfoque no existe una comparación directa con el efecto observado en el estudio original. La pregunta ya no es exactamente «¿se replicó el efecto original?», sino «si repetimos el procedimiento original, ¿observamos un efecto estadísticamente significativo?». Es decir, no estamos comprobando si se ha replicado el tamaño del efecto observado, sino si se ha repetido la afirmación ordinal de que existe un efecto distinto de cero. En el ejemplo de la Figura 17.2, la replicación tiene un tamaño del efecto de cero, por lo que no existe un resultado significativo y el efecto original no se replicó en este sentido.
Conviene detenerse y preguntar qué prueba estadística refleja mejor la pregunta «¿se replicó este estudio?». Por una parte, parece razonable considerar que un efecto no se ha replicado cuando existe una diferencia estadísticamente significativa entre los tamaños del efecto. Sin embargo, esto puede hacer que una replicación no significativa se clasifique como «replicación» simplemente porque su tamaño del efecto no sea estadísticamente menor que el original. Por otra parte, parece razonable considerar replicado un efecto cuando es significativo en la replicación. Pero ambos criterios pueden entrar en conflicto: algunos efectos de replicación son significativos y, al mismo tiempo, significativamente menores que el original. ¿Debemos considerarlos replicados?
Podríamos combinar ambas pruebas y considerar que existe replicación únicamente si el efecto de la replicación es estadísticamente distinto de cero —por ejemplo, p < .05— y, simultáneamente, la diferencia entre los tamaños del efecto no es estadísticamente distinta de cero —por ejemplo, p > .05 en la prueba de heterogeneidad—. Lógicamente, una no replicación clara se produciría cuando ocurre lo contrario: p > .05 en la prueba de significación de la replicación y p < .05 en la prueba de heterogeneidad.
El problema es que, debido a la baja potencia de la prueba que compara el tamaño del efecto original con el de la replicación, resulta difícil alcanzar un resultado informativo. En la práctica, muchas replicaciones no significativas tampoco mostrarán una diferencia significativa frente al estudio original. Richard Morey y yo (Morey y Lakens 2016) resumimos este problema en el título de un preprint que nunca llegamos a reenviar tras recibir revisiones positivas: Why most of psychology is statistically unfalsifiable. Si exigiéramos ambos criterios, gran parte de las replicaciones conducirían a resultados inconclusos.
El problema es todavía mayor si aceptamos que algunos efectos son demasiado pequeños para importar. Anderson y Maxwell (Anderson y Maxwell 2016) señalan que podemos combinar la comparación entre los tamaños del efecto con una prueba de equivalencia para determinar si la diferencia —en caso de existir— es demasiado pequeña para resultar relevante. Con muestras enormes, diferencias minúsculas entre estudios pueden resultar estadísticamente significativas y llevarnos a concluir que un estudio no se replicó aunque la diferencia sea insignificante desde un punto de vista práctico o teórico.
Anderson y Maxwell también subrayan la necesidad de incorporar un tamaño del efecto mínimo de interés al interpretar un resultado nulo en una replicación. Por ejemplo, McCarthy et al. (McCarthy et al. 2018) replicaron un estudio de priming de hostilidad cuyo tamaño del efecto original había sido \(d = 3.01\). En una replicación multilaboratorio observaron un efecto casi nulo: \(d = 0.06\), IC del 95 % [0.01, 0.12]. El efecto era estadísticamente diferente del original y, al mismo tiempo, estadísticamente significativo. Sin embargo, McCarthy y sus colaboradores argumentaron que, incluso siendo significativo, era demasiado pequeño para importar: para detectar de manera rutinaria un efecto de \(d = 0.06\) con una potencia del 80 % y \(\alpha = .05\) harían falta 4.362 participantes en cada condición.
¿Debemos considerar una replicación con \(d = 0.06\) como exitosa únicamente porque es significativa en una muestra enorme? Como se explicó en el capítulo sobre pruebas de equivalencia, los efectos muy cercanos a cero suelen considerarse equivalentes a la ausencia de efecto cuando son prácticamente irrelevantes, teóricamente menores de lo esperado o imposibles de investigar de manera fiable con los recursos disponibles. McCarthy et al. (McCarthy et al. 2018) sostienen que el diminuto efecto observado ya no es factible de estudiar de manera práctica, por lo que los psicólogos lo considerarían equivalente a un resultado nulo. Por ello, se recomienda especificar un tamaño del efecto mínimo de interés en los estudios de replicación —cuando sea posible, de acuerdo con los autores originales; véase el ejemplo de Morey et al. (2021)— y evaluar la replicación mediante una prueba de equivalencia frente a ese valor.
Como hemos visto, aunque idealmente deberíamos contrastar directamente ambos tamaños del efecto, la incertidumbre del estimador original puede producir una prueba con muy poca potencia cuando la muestra inicial es pequeña. No podemos aumentar retrospectivamente el tamaño muestral del estudio original y tampoco podemos hacer ciencia si nunca somos capaces de concluir que una afirmación de la literatura no se replica. Necesitamos, por tanto, alternativas pragmáticas. Una opción intuitiva consistiría en comprobar si el efecto de la replicación es estadísticamente menor que el efecto original, por ejemplo examinando si el intervalo de confianza del 95 % de la replicación excluye \(d = 0.6\) —o \(g = 0.592\) tras convertirlo a \(g\) de Hedges—. En esencia, sería una prueba bilateral frente al tamaño del efecto original. Pero esto equivale a convertir una prueba t independiente entre dos grupos en una prueba t de una muestra en la que ignoramos la incertidumbre de uno de ellos. No aceptaríamos esta lógica al comparar dos medias y tampoco deberíamos aceptarla al comparar dos diferencias de medias estandarizadas. La prueba rechazará demasiado fácilmente la hipótesis de que ambos efectos son iguales porque ignora la variabilidad de uno de ellos.
Una alternativa es contrastar la replicación frente a una estimación más conservadora y considerar no replicado el hallazgo original cuando pueda rechazarse ese tamaño del efecto conservador. En la práctica, a menudo interesa saber si el efecto de la replicación es estadísticamente menor que el original. Esta pregunta puede responderse mediante una prueba de inferioridad, que resulta significativa cuando el intervalo de confianza del 90 % de la replicación no contiene el tamaño del efecto conservador. Una implementación es el método de los telescopios pequeños (small telescopes) (Simonsohn 2015). En este enfoque se contrasta la replicación frente al tamaño del efecto que el estudio original tenía un 33 % de potencia para detectar. En el ejemplo de la Figura 17.2, el estudio original tenía un 33 % de potencia para detectar aproximadamente \(d = 0.4\).
pwr::pwr.t.test(
  n = 30,
  sig.level = 0.05,
  power = 0.33,
  type = "two.sample",
  alternative = "two.sided"
)
El intervalo de confianza del 95 % de la replicación permite rechazar efectos superiores a 0.277, de modo que un intervalo del 90 % permitiría rechazar tamaños todavía menores. Por tanto, el procedimiento de small telescopes permitiría concluir que el efecto original no se replicó. Este enfoque es especialmente popular al replicar estudios originales pequeños, porque cuanto menor sea su muestra, mayor será el efecto que tenían un 33 % de potencia para detectar y más fácil resultará rechazarlo en la replicación. Es exactamente lo contrario de lo que ocurre al comparar directamente los dos tamaños del efecto, donde una muestra original pequeña reduce la potencia.
Una crítica razonable al procedimiento de small telescopes es que la convención del 33 % es completamente arbitraria. Idealmente, los investigadores especificarían el tamaño del efecto mínimo de interés y realizarían una prueba de inferioridad frente al efecto más pequeño que realmente importara. Definir este valor es difícil. En algunos casos, los autores del estudio original pueden especificarlo. Por ejemplo, en una replicación multilaboratorio del efecto de compatibilidad acción-oración, los investigadores originales indicaron que un efecto de 50 milisegundos o menos sería teóricamente despreciable (Morey et al. 2021). El gran tamaño muestral permitió rechazar de manera concluyente efectos iguales o mayores que ese límite. Otra opción consiste en fijar el tamaño mínimo a partir de predicciones teóricas o por encima del crud factor, es decir, del tamaño de los efectos que aparecen en una literatura debido a ruido sistemático teóricamente poco interesante (Orben y Lakens 2020). Ferguson y Heene (Ferguson y Heene 2021) proponen, por ejemplo, \(r = 0.1\) —o \(d = 0.2\)— porque tamaños de esta magnitud pueden observarse entre variables absurdas y estar impulsados únicamente por factores de confusión metodológicos.
También se ha propuesto combinar el efecto del estudio original y el de la replicación mediante un metaanálisis y comprobar si el efecto metaanalítico es estadísticamente distinto de cero. Este enfoque puede ser interesante en ausencia de sesgos, pero cuando existen sesgo de publicación o sesgo de selección sus debilidades superan a sus ventajas. Como ambos inflan los tamaños del efecto, también inflarán el efecto metaanalítico y, con ello, la probabilidad de obtener una significación estadística incluso cuando no existe efecto real.
17.4 ¿Estudios de replicación o niveles alfa más bajos?
Quienes tienen una orientación especialmente estadística señalan a veces que, en términos de probabilidad de error de tipo I, no hay diferencia entre poner a prueba una hipótesis una sola vez con un nivel alfa más bajo —por ejemplo, \(0.05 \times 0.05 = 0.0025\)— y probarla en dos estudios independientes con \(\alpha = 0.05\). Esto es correcto, pero en la práctica no podemos sustituir la función de las replicaciones simplemente reduciendo alfa en un único estudio.
Reducir alfa hasta una probabilidad deseada de error de tipo I exigiría que los científicos 1) pudieran predecir perfectamente la importancia futura de una afirmación y 2) fueran capaces de alcanzar un consenso sobre la tasa de error de tipo I colectivamente aceptable para cada afirmación. Ninguna de las dos cosas ocurre en la práctica. Una afirmación puede ganar importancia con el tiempo porque muchos trabajos posteriores la citen y la den por verdadera. Ese aumento de importancia puede hacer que toda la comunidad considere valioso reducir la probabilidad de error mediante una replicación, porque un error de tipo I se ha vuelto más costoso (Isager et al. 2023). En cambio, si nadie construye sobre una afirmación, quizá nadie tenga interés en reducir aún más su error. No podemos saber de antemano cuán importante será una afirmación para la investigación futura.
La segunda razón es que existen diferencias individuales entre investigadores acerca de cuándo consideran que un hallazgo está suficientemente demostrado. Popper escribe: «Toda prueba de una teoría, conduzca a su corroboración o falsación, debe detenerse en algún enunciado básico que decidimos aceptar». Y añade: «Este procedimiento no tiene un final natural. Si queremos que la prueba nos lleve a algún sitio, no queda más remedio que detenernos en algún punto y decir que estamos satisfechos, por el momento». Algunos investigadores pueden sentirse satisfechos con una probabilidad de error de tipo I del 10 %, mientras que otros más escépticos quizá quieran reducirla al 0.1 % antes de construir sobre el hallazgo.
Utilizar un alfa muy bajo en un único estudio no ofrece a la ciencia la flexibilidad de seguir reduciendo la probabilidad de error cuando surge la necesidad; realizar replicaciones sí lo permite. Conviene pensar cuidadosamente en la tasa de error deseada y, cuando los errores de tipo I sean costosos, utilizar un alfa inferior al convencional 0.05 (Maier y Lakens 2022). Pero las replicaciones seguirán siendo necesarias para reducir progresivamente el error cuando una afirmación gane importancia o cuando algunos investigadores requieran evidencia más fuerte.
Existe además otra razón por la que las replicaciones independientes son preferibles a una simple reducción de alfa. Si otras personas consiguen replicar independientemente el mismo efecto, disminuye la probabilidad de que el hallazgo original se deba a un error sistemático. Los errores sistemáticos no se promedian hasta desaparecer a largo plazo, como sí ocurre con los errores aleatorios. Pueden proceder de numerosas fuentes. Por ejemplo, una báscula limitada a 150 kg podría impedir detectar un aumento de peso que sí sería visible con una báscula de mayor capacidad. También el propio experimentador puede introducir un error sistemático: el efecto observado podría deberse no a la manipulación, sino a que trata de manera diferente a los participantes de cada condición. Otros experimentadores que repitan la manipulación sin ese sesgo podrían observar resultados distintos.
Cuando un investigador repite su propio experimento hablamos de autorreplicación; cuando lo repiten otros investigadores hablamos de replicación independiente. La autorreplicación puede reducir la tasa de error de tipo I de una afirmación, mientras que la replicación independiente puede, además, reducir la probabilidad de que la afirmación esté causada por un error sistemático. Ambas son útiles. Por ejemplo, las colaboraciones del Gran Colisionador de Hadrones del CERN no solo replican resultados utilizando el mismo detector, sino también entre detectores diferentes. El LHC cuenta con cuatro grandes detectores —ATLAS, CMS, ALICE y LHCb—. Un experimento puede autorreplicarse recogiendo más datos con el mismo detector —lo que los físicos denominan una replica— o puede replicarse mediante otro detector.
Junk y Lyons (2020) señalan que en una autorreplicación «se espera que las variaciones estadísticas sean distintas entre la réplica y el original, pero que las fuentes de error sistemático permanezcan iguales». Realizar el mismo experimento en un detector diferente permite investigar esos errores sistemáticos. Los detectores del CERN no son copias exactas unos de otros; por ello, observar el mismo resultado con dos configuraciones ligeramente diferentes aumenta la confianza en la fiabilidad de la conclusión.
El valor de una replicación independiente no reside únicamente en reducir la probabilidad de error de tipo I, sino también en disminuir la preocupación por la influencia de errores sistemáticos (Neher 1967). Mack (1951) ya señalaba que «la introducción de técnicas diferentes proporciona a la replicación la ventaja adicional de servir como comprobación de la validez de la investigación original». Lubin (1957) expresaba una idea similar: «Nuestra confianza en un estudio será una función monótona positiva de la medida en que los diseños de replicación varíen esos factores supuestamente irrelevantes». En resumen, tanto la autorreplicación como la replicación independiente reducen la probabilidad de una afirmación falsa positiva, pero la segunda añade una prueba de generalización frente a factores que se suponían irrelevantes.
Desde un punto de vista puramente estadístico, resulta interesante preguntar qué cuesta menos en términos de tamaño muestral: realizar un único estudio con \(\alpha = 0.0025\) o dos estudios con \(\alpha = 0.05\). Si para alcanzar una potencia determinada se necesitara una muestra mucho menor en el primer caso, existiría un argumento para preferir grandes estudios únicos frente a dos estudios menores.
Para una prueba t independiente, la estrategia más eficiente depende de la potencia deseada y de si la prueba es bilateral o unilateral. La Figura 17.4 muestra la razón entre el tamaño muestral necesario para un estudio con \(\alpha = 0.0025\) y el total de dos estudios con \(\alpha = 0.05\). Una razón igual a 1 indica que ambas estrategias requieren el mismo número de observaciones. En las pruebas bilaterales, la razón desciende por debajo de 1 cuando la potencia es elevada. Por ejemplo, para detectar \(d = 0.5\) con una potencia del 80 %, un estudio con \(\alpha = 0.0025\) necesita un tamaño total de 244 participantes; con \(\alpha = 0.05\), cada estudio necesita 128 participantes. La razón es \(244/(128+128)=0.95\), por lo que el estudio único ahorra 12 observaciones.

Sin embargo, existen argumentos fuertes a favor de las pruebas direccionales, especialmente en estudios de replicación. En una prueba unilateral las razones cambian: un estudio grande con \(\alpha = 0.0025\) puede ser ligeramente más eficiente para algunos tamaños del efecto cuando la potencia deseada es del 90 %, pero con una potencia del 80 % resulta más eficiente realizar dos pruebas con \(\alpha = 0.05\). Para detectar \(d = 0.5\) con un alfa de 0.0025 y una potencia del 80 % se necesita un tamaño total de 218; con alfa 0.05 se necesitan 102 participantes en cada estudio. La razón es \(218/(102+102)=1.07\), por lo que realizar dos estudios ahorra 14 observaciones.
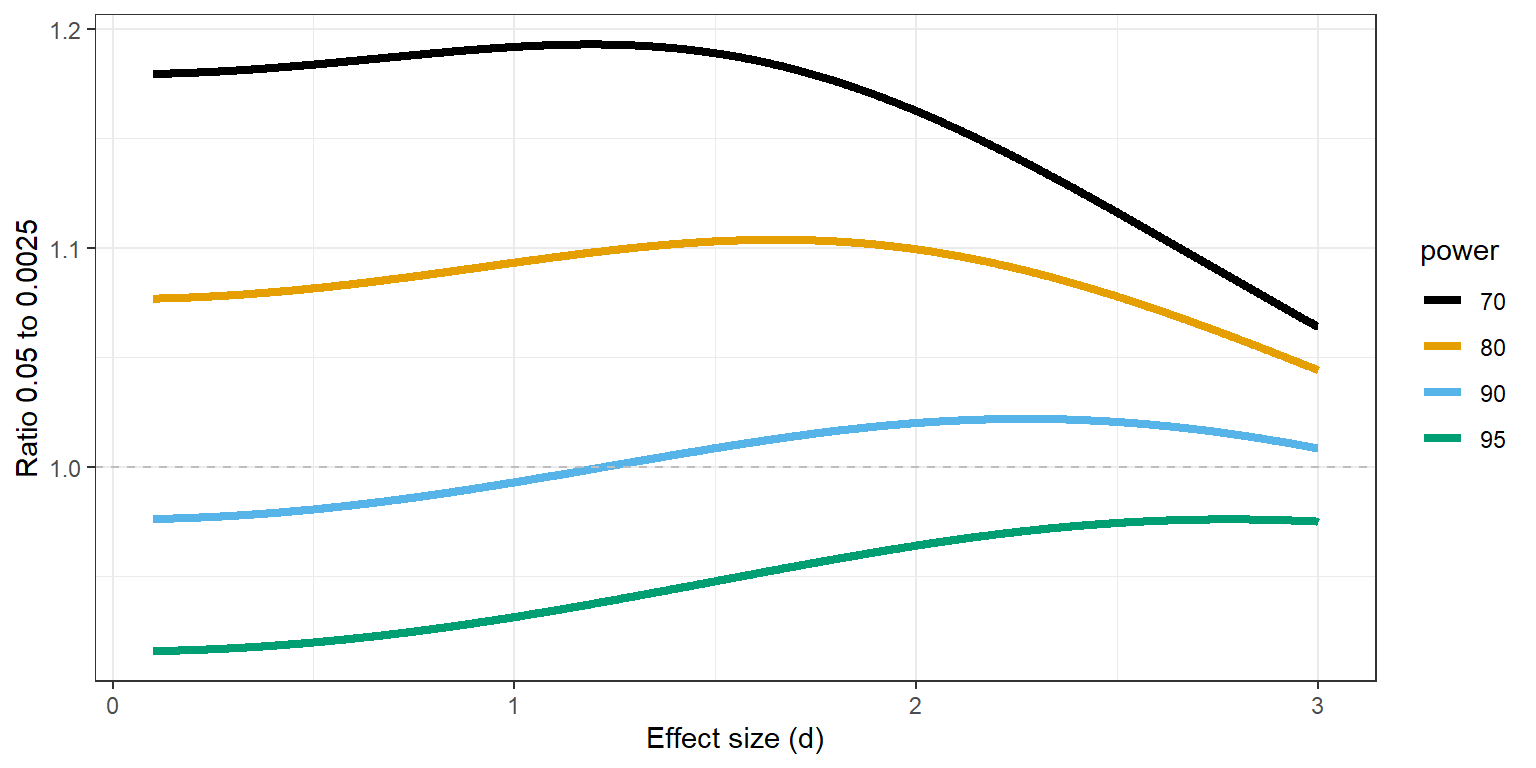
La potencia estadística de ambos escenarios es idéntica en estos cálculos, aunque debemos considerar cómo se analizarán los dos estudios con alfa 0.05. Si son replicaciones directas, un metaanálisis de efecto fijo de ambos tamaños del efecto tiene la misma potencia que un único estudio con el doble de muestra; por tanto, un metaanálisis con alfa 0.0025 sería equivalente a un único estudio del mismo tamaño total y alfa 0.0025. En conjunto, la elección entre dos estudios con alfa 0.05 y uno con alfa 0.0025 depende de la direccionalidad de la prueba y de la potencia deseada. No existe una ventaja inequívoca del estudio único. Dadas las ventajas no estadísticas de las replicaciones independientes y el argumento de que las replicaciones deberían ser pruebas direccionales, puede defenderse la estrategia de dos estudios. Eso exige colaboración entre científicos y que todos los estudios se compartan con independencia de su resultado —por ejemplo, mediante Registered Reports—.
17.5 Cuando los estudios de replicación producen resultados contradictorios
Como se señaló antes, una no replicación tiene tres posibles explicaciones: la replicación produjo un error de tipo II, el estudio original fue un error de tipo I o existe alguna diferencia relevante entre ambos estudios. La probabilidad de un error de tipo II puede reducirse mediante un análisis de potencia a priori o, todavía mejor, mediante un análisis de potencia para una prueba de equivalencia frente a un tamaño del efecto mínimo de interés. Aun así, siempre existirá cierta probabilidad de que el resultado de una replicación sea un falso negativo.
Algunos investigadores sostienen que los fracasos de replicación pueden explicarse mediante moderadores hasta entonces desconocidos u «ocultos» (Stroebe y Strack 2014). Existe al menos un ejemplo en el que se encontró apoyo modesto para la idea de que una replicación fallida se debía al grado de relevancia personal del mensaje utilizado en el estudio (Luttrell et al. 2017). Sin embargo, identificar de forma fiable moderadores que expliquen las no replicaciones es difícil, mientras que proponerlos retrospectivamente cuando el efecto no aparece es muy sencillo. En las ciencias sociales, algunos moderadores potenciales son además prácticamente imposibles de poner a prueba, como el hecho de que la sociedad haya cambiado con el tiempo.
Este problema es muy antiguo. Galileo ya lo señaló en The Assayer, uno de los primeros libros sobre el método científico. Allí comenta la afirmación de que los babilonios cocían huevos haciéndolos girar en una honda, algo que resultó imposible de replicar:
«Si no conseguimos un efecto que otros lograron anteriormente, debe de ser porque nos falta algo en nuestra operación que era la causa de que el efecto tuviera éxito; y si solo nos falta una cosa, entonces esa debe ser la verdadera causa. Ahora bien, no nos faltan huevos, ni hondas, ni hombres robustos que los hagan girar, y aun así no se cuecen; más bien se enfrían más deprisa si estaban calientes. Y como no nos falta nada excepto ser babilonios, entonces ser babilonio es la causa de que el huevo se endurezca».
Al mismo tiempo, algunos fracasos de replicación sí se deben a diferencias en hipótesis auxiliares. En uno de los estudios más interesantes sobre esta cuestión, Ebersole et al. (2020) realizaron replicaciones adicionales de diez estudios incluidos previamente en el Reproducibility Project: Psychology (Open Science Collaboration 2015). Cuando se diseñaron las primeras replicaciones, se pidió a los autores originales que comentaran el protocolo. En estos diez casos plantearon preocupaciones que finalmente no se incorporaron. Algunos señalaron, por ejemplo, que la replicación incluía participantes que ya habían cursado asignaturas de psicología o economía, o que habían participado anteriormente en experimentos, y predijeron que los efectos serían mayores entre participantes «ingenuos». Otros señalaron que los estímulos no se habían pilotado suficientemente, que la recogida se realizaba en otro país, que los materiales eran diferentes o incluso que existían diferencias en la resolución de las pantallas utilizadas.
Todas estas preocupaciones implicaban predicciones acerca de hipótesis auxiliares. Un equipo de 172 investigadores colaboró con los autores originales para ponerlas a prueba en Many Labs 5 (Ebersole et al. 2020). El proyecto es especialmente informativo porque se realizaron grandes replicaciones tanto del protocolo del RP:P como de un protocolo revisado que incorporaba las preocupaciones de los autores.
Los resultados ilustran lo difícil que es predecir si un hallazgo se replicará antes de intentarlo (Miller 2009). Dos estudios que no se replicaron en el RP:P tampoco lo hicieron al repetir el protocolo con una muestra mayor, pero sí produjeron un efecto con el protocolo revisado. Sin embargo, esos efectos eran posiblemente triviales —Albarracin et al., Estudio 5, y Shnabel & Nadler en la Figura 17.6—. Un tercer estudio, de Van Dijk et al., mostró un patrón similar pero quedó justo por debajo de la significación con el protocolo revisado. Un cuarto, Albarracin et al., Estudio 7, había sido apenas significativo en el original; el RP:P observó un tamaño del efecto muy parecido pero apenas no significativo, de modo que un metaanálisis de ambos habría resultado significativo. Sorprendentemente, tanto la nueva replicación del protocolo RP:P como el protocolo revisado produjeron después resultados nulos claros. Un quinto estudio, Crosby et al., mostró un patrón parecido: original y RP:P apuntaban en la misma dirección, y las nuevas replicaciones no resultaron significativas, aunque los tamaños del efecto de los cuatro estudios eran muy similares y el metaanálisis conjunto producía un pequeño efecto significativo. En total, seis de los diez casos pueden considerarse no replicaciones claras en las que las preocupaciones de los autores no explicaron el resultado: solo el estudio original fue significativo y ninguna de las replicaciones lo fue.
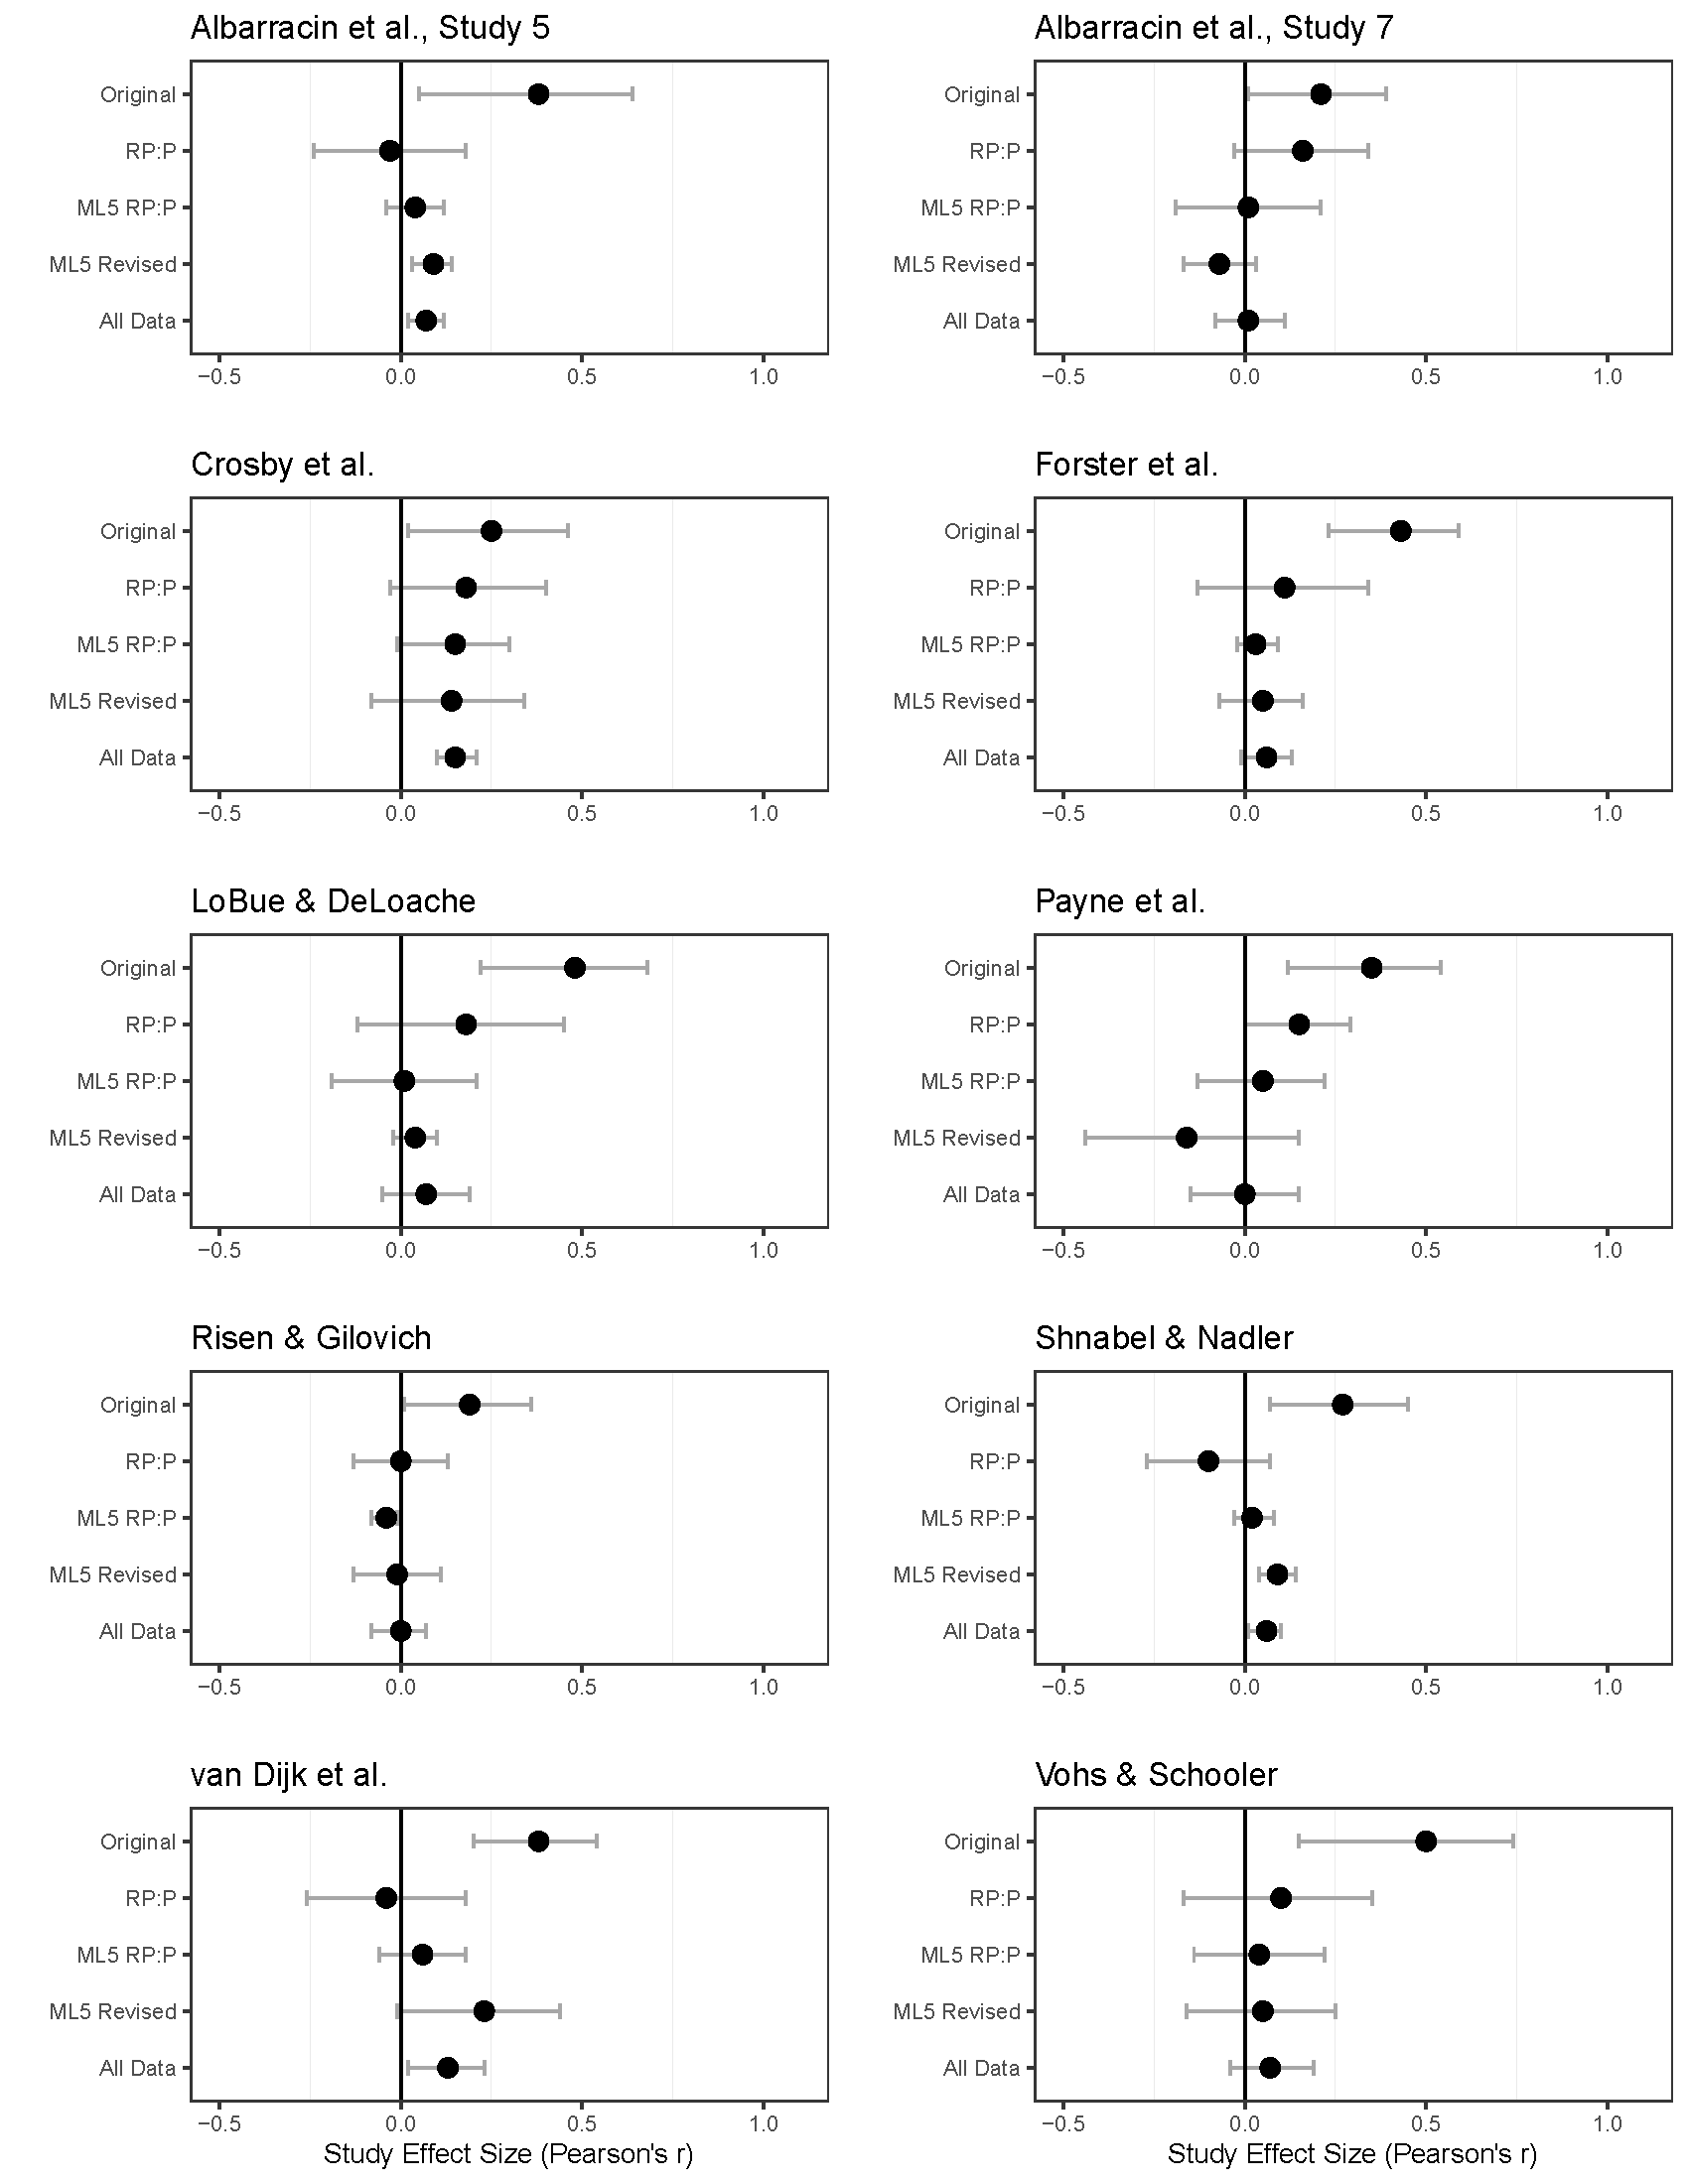
No podemos concluir, sin embargo, que las preocupaciones planteadas por los autores explicaran los otros cuatro casos. A pesar de los grandes tamaños muestrales, solo se observó una diferencia estadísticamente significativa entre el protocolo RP:P y el protocolo revisado —Payne et al.—, y en este caso los cambios sugeridos por los autores produjeron un tamaño del efecto todavía más alejado del original cuando ambos se comparan mediante una prueba de heterogeneidad:
# Payne, Burkley, & Stokes (2008)
# El IC de la figura es amplio porque existe una variabilidad considerable
# entre los centros, especialmente en el protocolo revisado.
r1 <- escalc(ni = 545,
             ri = 0.05,
             measure = "ZCOR")
r2 <- escalc(ni = 558,
             ri = -0.16,
             measure = "ZCOR")
metadata <- data.frame(yi = c(r1$yi, r2$yi),
                       vi = c(r1$vi, r2$vi),
                       study = c("original", "replication"))

res_h <- rma(yi,
             vi,
             data = metadata,
             method = "FE")
res_h
Fixed-Effects Model (k = 2)
I^2 (total heterogeneity / total variability): 91.84%
H^2 (total variability / sampling variability): 12.26
Test for Heterogeneity:
Q(df = 1) = 12.2578, p-val = 0.0005
Model Results:
estimate se zval pval ci.lb ci.ub
-0.0569 0.0302 -1.8854 0.0594 -0.1161 0.0023Las demás diferencias entre el protocolo RP:P y el revisado no fueron estadísticamente significativas. En otro estudio, el nuevo protocolo desplazó el tamaño del efecto todavía más lejos del original; en los otros dos, el efecto se acercó al del estudio original. En conjunto, los autores que expresan preocupaciones sobre un protocolo de replicación no parecen tener una tasa de éxito especialmente alta al predecir qué hipótesis auxiliares modificarán realmente el tamaño del efecto observado. Esta es una conclusión muy importante de Many Labs 5.
17.6 ¿Por qué son tan raros los estudios de replicación?
«Es difícil negar que existe más emoción, y normalmente más gloria, en abrir un camino nuevo que en comprobar el trabajo del pionero» (Mack 1951). A lo largo de la historia, numerosos investigadores han señalado que las estructuras de incentivos premian la investigación novedosa por encima de las replicaciones (Koole y Lakens 2012; Fishman y Neigher 1982; Vaesen 2026). Realizar replicaciones constituye un dilema social: es bueno para todos que los científicos hagan estudios de replicación, pero para un científico individual suele ser mejor, desde el punto de vista profesional, realizar un estudio novedoso.
Es difícil saber con precisión cuántas replicaciones se realizan porque no existe una base de datos completa que las registre todas; pueden consultarse, no obstante, Curate Science, la Replication WIKI y la Replication Database.
Aunque las estructuras de incentivos no han cambiado por completo, sí se han producido avances positivos. Al comienzo de la crisis de replicación, varias replicaciones fallidas del estudio de precognición de Bem fueron rechazadas editorialmente por Eliot Smith, editor de JPSP, quien afirmó: «Esta revista no publica estudios de replicación, tengan éxito o fracasen» y «No queremos convertirnos en el Journal of Bem Replication» (Aldhous 2011). La reacción pública a esta decisión contribuyó a que numerosas revistas comenzaran a declarar explícitamente que aceptaban replicaciones.
Cada vez más revistas aceptan Registered Reports, que pueden consistir en estudios de replicación, y la iniciativa Peer Community In: Registered Reports también publica replicaciones. La APA ha elaborado directrices específicas para comunicar estudios de replicación, y algunos organismos financiadores han creado convocatorias específicas para investigación de replicación.
Al mismo tiempo, las replicaciones siguen recibiendo menos recompensa profesional que el trabajo novedoso, de modo que quienes intentan construir una carrera científica continúan teniendo incentivos para priorizar la novedad. Por ello, pese a los avances, en muchas disciplinas todavía queda camino por recorrer antes de que los estudios de replicación formen parte normal y cotidiana de la investigación científica.